Season 1 dan Season 2 sudah saya tutup: dari regresi linear sampai multi-agent, dari confusion matrix sampai cost optimization di produksi. Hari ini saya mulai Season 3, dan fokusnya saya geser total — bukan lagi “bisa pakai AI”, tapi “bisa meluncurkan produk AI”. Istilahnya beda tipis di marketing, tapi di lapangan jaraknya jauh: memanggil API dan membuat prompt yang jalan di laptop itu mudah; membuatnya tetap jalan di production dengan latency yang wajar, biaya yang terkendali, dan kegagalan yang tidak memalukan itu cerita lain.
Kesenjangan yang mau saya tutup
Selama dua season saya banyak memakai analogi “kotak hitam”: kasih input, keluar output, kita nilai dari luar. Di Season 3 saya mau membongkar kotak itu. Kenapa transformer bisa menghitung attention seperti itu, kenapa model bisa “salah hitung” saat diminta menjumlahkan, kenapa satu prompt yang sama bisa berbeda hasilnya antar provider. Bagi saya ini penting bukan demi teori, tapi supaya saat ada bug saya tahu harus menyalahkan bagian mana: modelnya, datanya, promptnya, atau memang ekspektasi saya yang salah.
Ini yang saya sadari setelah menulis episode evals seperti #30 Evals: selama ini saya menguji kode dengan unit test, tapi model AI hampir tidak pernah saya uji secara sistematis. Kebiasaan buruk programmer yang paling mahal di AI adalah mengandalkan “sudah saya coba beberapa kali, kelihatannya oke”.
Peta musim ini
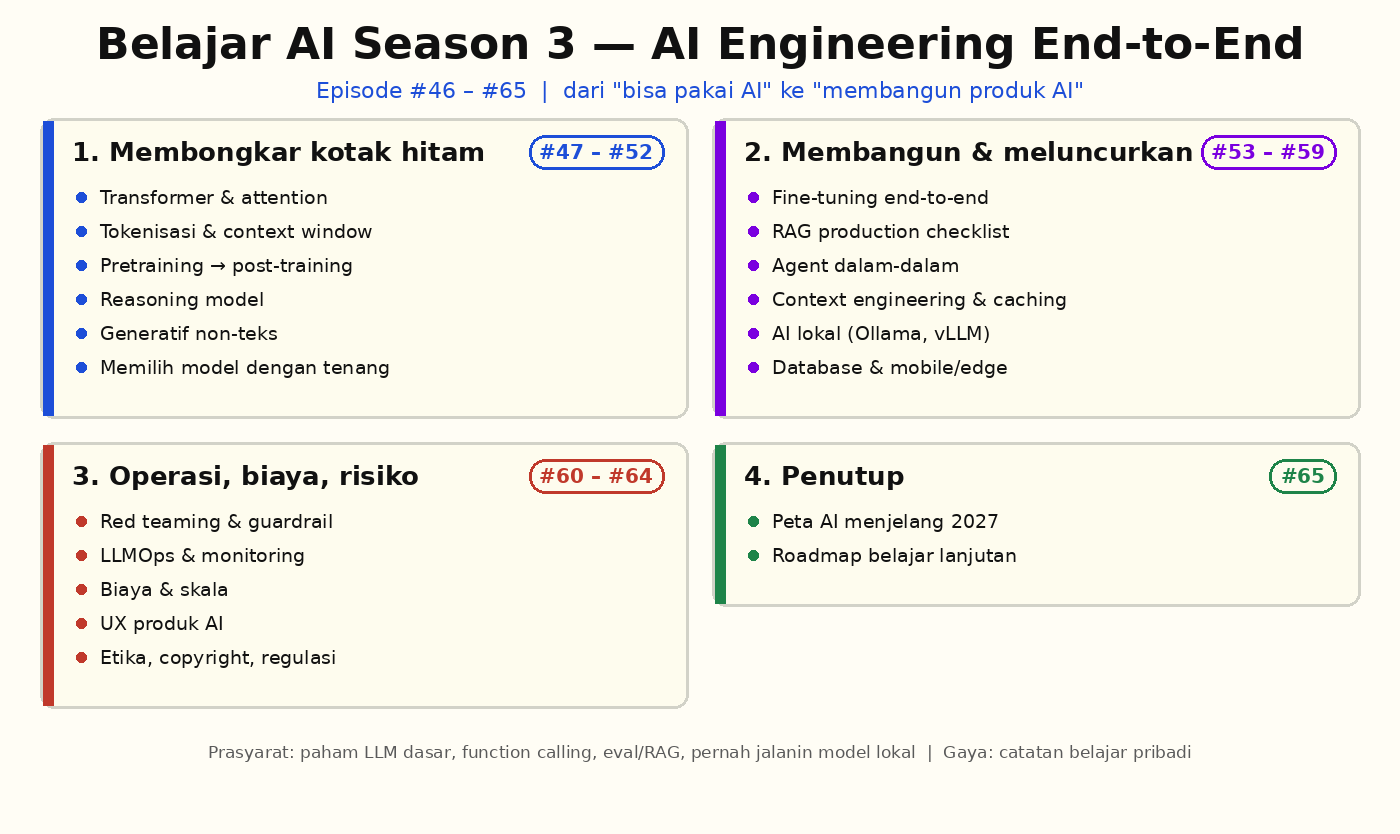
| Blok | Episode | Pertanyaan yang dijawab |
|---|---|---|
| Membongkar kotak hitam | #47–#52 | Transformer, tokenisasi, pipeline training, reasoning model, model generatif non-teks, cara memilih model dengan tenang |
| Membangun & meluncurkan | #53–#59 | Fine-tuning end-to-end, RAG production, agent dalam-dalam, context engineering, AI lokal, database, mobile/edge |
| Operasi, biaya, risiko | #60–#64 | Red teaming, LLMOps, perhitungan biaya & skala, UX produk AI, etika & regulasi |
| Penutup | #65 | Peta AI menjelang 2027 dan roadmap belajar lanjutan |
Urutan ini sengaja tidak saya acak. Saya pernah ingin langsung loncat ke “biaya & skala” karena paling terasa urgennya, tapi sadar tanpa paham cara kerja tokenisasi dan pipeline training, angka-angka biaya akan terasa seperti angka arbitrer. Analoginya: sebelum optimasi database, pahami dulu kenapa query-nya lambat.
Prasyarat yang saya asumsikan sudah ada
- Paham konsep dasar model: apa itu LLM, embedding, dan inference — materi Season 1 dan pembuka #26.
- Bisa memanggil API LLM dan menulis function calling — #27 dan #28 MCP.
- Pernah menyentuh eval dan RAG sekilas — #30 dan #31.
- Pernah menjalankan model lokal minimal sekali — #24 GGUF.
Kalau prasyarat itu belum ada, saya sarankan baca dulu episode terkait — bukan karena saya mau menambah pembaca, tapi karena materi Season 3 banyak yang memakai istilah dari sana. Saya sendiri pernah melompati prasyarat dan akhirnya menghabiskan dua kali waktu untuk memahami hal yang seharusnya sudah saya tahu.
Cara belajar yang saya pakai musim ini
Saya ubah dari “baca lalu catat” jadi “bangun lalu catat”. Untuk tiap topik engineering, saya mau menuliskan minimal satu hal yang saya jalankan sendiri: satu model yang saya inference di laptop, satu pipeline RAG yang saya ukur groundedness-nya, satu perhitungan biaya dengan angka provider yang saya cek langsung. Kalau tidak bisa dijalankan, minimal saya tulis kenapa tidak bisa — itu pun catatan yang berguna.
Saya juga menyiapkan daftar pertanyaan yang akan saya pakai menilai tiap episode: apa yang sekarang bisa saya jelaskan ke rekan kerja, apa yang sekarang bisa saya ukur, dan apa yang sekarang saya tahu tidak boleh dilakukan di production. Kalau ketiganya terjawab, menurut saya episode itu berhasil.
Penutup pembuka
Episode berikutnya saya mulai dari #16 Transformer yang dulu saya bahas dari sisi teori — kali ini dari sisi engineering: multi-head attention, positional encoding, dan kenapa arsitektur ini yang menang. Ini catatan belajar saya untuk musim yang lebih berat, dan seperti biasa, saya akan menulis sejujur mungkin bagian mana yang sulit.
Sumber
- Attention Is All You Need — Vaswani dkk., arXiv 2017 (dasar arsitektur transformer).
- Language Models are Few-Shot Learners — Brown dkk., arXiv 2020 (GPT-3 & in-context learning).
- Prompt caching — dokumentasi Anthropic (contoh teknik yang akan dibahas di #56).
- Hugging Face Transformers documentation (referensi praktik pipeline training, #49).
- Arsip seri Belajar AI di Catatan Rudy (Season 1–2, episode #1–#45).
Komentar Terbaru