Empat episode terakhir, #46 sampai #50, saya habiskan untuk membongkar kotak hitam teks: transformer dari dalam, tokenisasi dan context window, pipeline pretraining ke post-training, sampai reasoning model. Mulai dari catatan ini saya ingin melebarkan pandangan ke modalitas lain. Produk AI yang saya pakai sehari-hari jarang berhenti di teks: thumbnail, klip pendek, musik latar, semuanya keluar dari model generatif non-teks. Di episode #18 (Generative AI) saya sempat menyentuh diffusion dari jauh; kali ini saya mau membedahnya lebih dalam sambil memetakan nama model yang masih hidup per November 2026.
Gambar tidak ditebak baris demi baris, tapi dibersihkan dari bising
Ini yang paling mengubah cara saya melihatnya. Untuk teks, model menebak satu token berikutnya — urut, baris demi baris, seperti kita menulis kode. Gambar tidak punya urutan alami: piksel ke-10.000 tidak lebih penting dari piksel ke-10.001. Karena itu diffusion membalik masalahnya. Model dilatih untuk menebak “bising apa yang ada di gambar ini”, lalu bising itu dikurangi berulang kali — 20 sampai 50 langkah — sampai yang tersisa gambar bersih. Analogi yang paling membantu buat saya: path tracing di renderer. Satu render keluar berisik, tambah sampel, tambah iterasi, makin jernih. Diffusion adalah optimasi iteratif yang dibalik arah.
Tiga efisiensi membuat model seperti ini muat di GPU biasa. Pertama, latent diffusion: jangan diffus di ruang piksel yang besar, kompres dulu ke ruang tersembunyi lewat VAE, baru diffus di sana (Rombach dkk., 2022). Kedua, backbone transformer (DiT) menggantikan U-Net lama. Ketiga, distilasi langkah — model “turbo” yang menghasilkan gambar layak dalam 4 langkah, bukan 50. Pola ini sama persis dengan yang saya catat di episode #38 soal optimasi inferensi: mengorbankan sedikit presisi demi latensi yang jauh turun.
Peta model gambar: yang terbuka dan yang tertutup
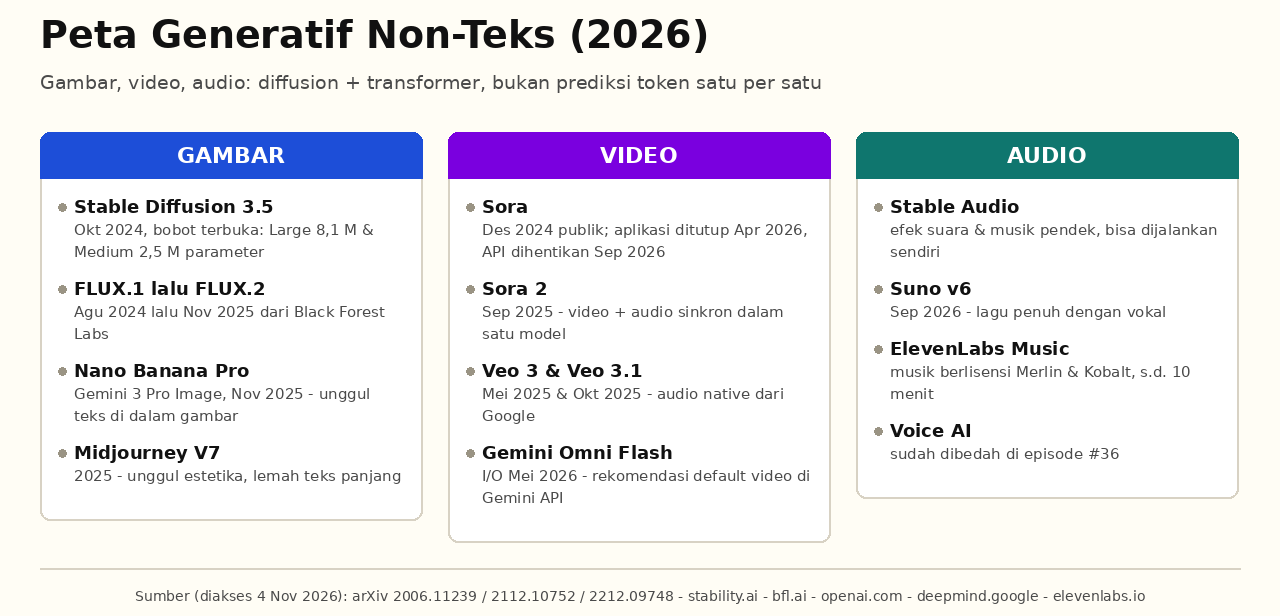
Di sisi terbuka, Stable Diffusion masih rujukan. Stable Diffusion 3.5 rilis 22 Oktober 2024 dengan varian Large (8,1 miliar parameter) dan Large Turbo (4 langkah), lalu Medium (2,5 miliar) pada 29 Oktober 2024, semuanya di bawah lisensi komunitas yang gratis selama pendapatan tahunan di bawah 1 juta dolar. Varian SD 1.5 dari 2022 pun masih hidup di komunitas karena ringan dan gampang dimodifikasi. Lalu ada FLUX dari Black Forest Labs (didirikan peneliti eks-Stability AI): FLUX.1 pada Agustus 2024, FLUX.1 Kontext untuk editing gambar pada 29 Mei 2025, dan FLUX.2 pada 25 November 2025 yang varian Klein-nya berlisensi Apache 2.0.
Di sisi tertutup, pemenang perbandingan pihak ketiga sekarang biasanya Nano Banana Pro (Gemini 3 Pro Image, November 2025) untuk teks di dalam gambar dan Midjourney V7 (2025) untuk estetika — V7 justru lemah untuk teks panjang. Keputusan engineering saya sederhana: volume besar dan butuh kontrol penuh → jalur terbuka; butuh kualitas, editing, dan konsistensi karakter cepat → jalur API. Perhitungan biayanya saya bahas lebih lanjut di episode #43.
Video: paling cepat berubah, paling mudah patah
Video pada dasarnya diffusion di atas patch spasi-waktu: satu detik berisi puluhan frame, jadi kebutuhan token melonjak dan konteks langsung sesak — persis masalah yang saya catat di episode #48. OpenAI memamerkan Sora pada Februari 2024 dan merilisnya ke publik 9 Desember 2024; Sora 2 menyusul 30 September 2025 dengan audio yang sinkron dengan gambar. Google masuk lewat Veo 3 (Mei 2025, audio native) lalu Veo 3.1 (Oktober 2025), tetapi di I/O Mei 2026 Google justru memperkenalkan Gemini Omni Flash sebagai rekomendasi default untuk video di Gemini API, dan rute Veo 3.1 Preview dimatikan pada 22 Oktober 2026.
Pelajaran yang paling saya pegang di sini: nama produk bisa mati cepat. Aplikasi Sora ditutup 26 April 2026 dan API-nya dihentikan 24 September 2026. Ini alasan saya tidak pernah menempel pipeline produk ke satu merek model — sediakan lapisan abstraksi supaya mengganti model cukup mengganti konfigurasi, bukan menulis ulang kode. Prinsip fallback yang sama sudah kita bangun di episode #43, dan cara memilihnya dengan tenang baru kita bahas di episode #52.
Audio: paling dekat dengan kantong, paling jarang dibedah
Audio pecah jadi tiga kategori yang beda masalahnya. Efek suara dan musik pendek dikuasai Stable Audio yang bisa dijalankan sendiri di mesin kita. Musik penuh dengan vokal dikuasai Suno (keluarga v6 sejak 9 September 2026) dan ElevenLabs Music yang bekerja dengan lisensi Merlin dan Kobalt, mampu menghasilkan lagu sampai 10 menit. Suara atau voice sudah saya bedah terpisah di episode #36. Cara kerjanya mirip dengan gambar: gelombang suara yang kontinu dikompres ke latent atau token codec, lalu di-generate dari sana. Karena itu musik AI masih sering melebar di bagian panjang — durasi panjang adalah masalah context window yang sama, cuma di modalitas lain.
Yang saya catat untuk meja kerja
- Non-teks tetap butuh eval, seperti yang saya bahas di episode #30 — hanya ukurannya yang berubah: preferensi manusia, kecocokan teks ke gambar, dan biaya per aset.
- Mulai dari API dulu. Self-host hanya kalau latensi, volume, atau privasi yang menuntut; soal bobot terbuka dan kuantisasi sudah ada di episode #24 dan #38.
- Saat merancang, kecepatan iterasi mengalahkan kualitas maksimum: pilih model yang bisa saya evaluasi ulang cepat.
- Watermark dan provenance (metadata C2PA) makin menjadi keharusan produk, bukan sekadar fitur tambahan.
Inti dari catatan ini satu: modalitas non-teks berubah jauh lebih cepat daripada teks, jadi tugas saya bukan menghafal nama modelnya, melainkan membangun lapisan yang gampang saya ganti. Di episode #52 kita lanjut ke cara memilih model dengan tenang, lengkap dengan red flag benchmark yang sering menipu.
Sumber
- Ho, J. dkk. (2020). Denoising Diffusion Probabilistic Models — arXiv.
- Rombach, R. dkk. (2022). High-Resolution Image Synthesis with Latent Diffusion Models — arXiv.
- Peebles, W. & Xie, S. (2023). Scalable Diffusion Models with Transformers — arXiv.
- Stability AI (2024). Introducing Stable Diffusion 3.5.
- Black Forest Labs. Repo resmi FLUX dan pengumuman FLUX.2.
- OpenAI (2025). Sora 2 is here — termasuk catatan penutupan produk April 2026.
- Google DeepMind. Halaman resmi Veo (Veo 3.1, status November 2026).
- ElevenLabs. Dokumentasi Eleven Music API; Stable Audio; Suno.
Komentar Terbaru