Memilih model LLM itu terasa seperti memilih framework di proyek baru: penuh benchmark, klaim “terbaik di kelasnya”, dan perbandingan yang berubah tiap bulan. Di catatan ini saya mencoba menyusun cara saya memilih model dengan tenang — bukan panik mengikuti papan peringkat, tapi menimbang tiga sumber sekaligus: Arena (dulu Chatbot Arena), benchmark publik, dan eval buatan sendiri. Saya juga mencatat tanda-tanda benchmark yang curiga, plus langkah praktis saat akhirnya harus memilih provider.
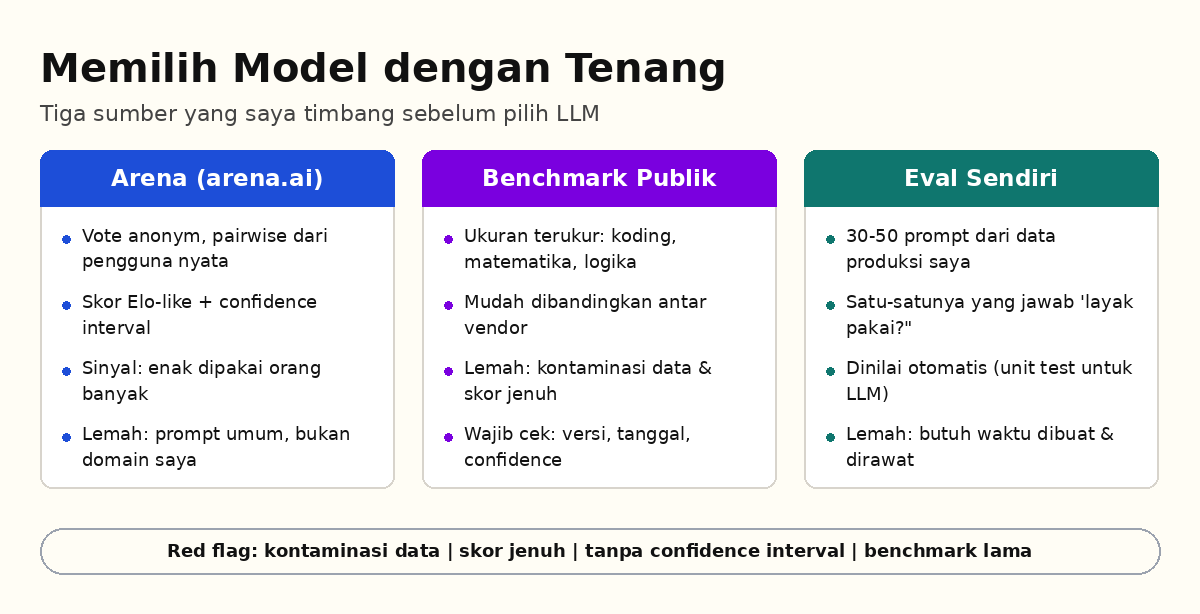
Tiga sumber, tiga pekerjaan berbeda
Pelajaran pertama saya: ketiganya tidak saling menggantikan. Arena menjawab “mana yang enak dipakai orang banyak”, benchmark publik menjawab “seberapa tinggi skornya di soal terukur”, dan eval sendiri menjawab “apakah model ini cocok untuk data dan kasus saya”. Setiap kali saya melompati eval sendiri karena malas, hasil produksi yang menanggungnya.
| Sumber | Jawab pertanyaan | Kelemahan |
|---|---|---|
| Arena (arena.ai) | Preferensi manusia nyata, anonym, pairwise | Prompt pengguna tidak mewakili domain saya |
| Benchmark publik | Kemampuan terukur (koding, matematika, reasoning) | Kontaminasi data & jenuh (lihat di bawah) |
| Eval sendiri | Kelayakan untuk produk saya | Butuh waktu bikin & merawat |
Arena: dari Chatbot Arena ke Arena
Saya sempat bingung sendiri dengan namanya. Platform ini lahir sebagai Chatbot Arena (April 2023, proyek LMSYS & UC Berkeley), pindah ke domain lmarena.ai pada September 2024, lalu pada 28 Januari 2026 berganti nama lagi menjadi Arena di arena.ai. Jadi Chatbot Arena = LMArena = Arena — satu produk, tiga nama. Menurut pengumuman resmi mereka, platformnya kini melayani lebih dari 5 juta pengguna per bulan dan sekitar 60 juta percakapan per bulan di 150 negara.
Cara kerjanya sederhana tapi cerdas: dua model menjawab pertanyaan Anda secara anonym, kita memilih mana yang lebih baik, lalu semua vote diolah memakai model Bradley-Terry (matematika yang sama untuk ranking tenis) menjadi skor Elo-like dengan confidence interval. Yang membuat saya percaya: hanya vote yang dibuat sebelum identitas model terbuka yang dihitung — kalau tahu dulu jawaban dari vendor X, penilaian kita sudah bias. Ada juga toggle Style Control yang menurunkan bobot jawaban panjang berformat rapi, supaya ranking tidak berubah jadi kontes siapa paling banyak memakai markdown.
Red flag benchmark yang perlu saya curigai
Di episode #30 saya sudah menulis soal eval sebagai “unit test untuk LLM”. Yang saya pelajari sejak itu: benchmark publik punya tiga penyakit yang sering tidak terlihat di siaran pers vendor.
- Kontaminasi data. Soal benchmark bocor ke data latih. Studi yang saya baca melaporkan 29,1% soal MMLU, 28,7% ARC-Challenge, 25% HumanEval, dan lebih dari 50% TriviaQA ditemukan di korpus pralatih — model bisa “hafal”, bukan berpikir. Di subset yang terkontaminasi, skor bisa melonjak sampai 44,5 poin persentase.
- Skor jenuh. GSM8k sudah menembus 96,7% untuk model 72B — hampir tidak ada ruang untuk membedakan model bagus dan sangat bagus. Kalau semua model di atas 95%, benchmark itu sudah tidak berguna untuk memilih.
- Paper vote rigging. Ada kertas arXiv (2025) yang mendemonstrasikan cara memanipulasi ranking Chatbot Arena. Papan peringkat apa pun yang bisa digame, akan digame.
Tanda praktis saat membaca pengumuman rilis: kalau vendor hanya menyebut benchmark yang sudah jenuh, tidak menyebut confidence interval, atau tidak menyebut versi benchmark & tanggal evaluasi — saya anggap itu marketing, bukan bukti.
Praktik memilih model dan provider
Setelah tiga kali salah pilih (mahal, lambat, atau jawabannya ngawur untuk data Indonesia), saya sekarang punya urutan tetap:
- Long-list dari Arena + benchmark relevan. Filter dulu 3–5 kandidat berdasarkan domain saya (koding, ringkasan dokumen, dll), bukan skor agregat.
- Bikin eval kecil sendiri. 30–50 prompt nyata dari data produksi saya, dinilai otomatis (lihat pola eval di episode #30). Ini yang paling menentukan.
- Cek harga & latensi aktual. Bandingkan pricing resmi per provider, bukan perbandingan blog pihak ketiga yang bisa basi.
- Siapkan jalur keluar. Karena API berubah cepat, saya selalu menulis lapisan abstraksi tipis supaya ganti model tinggal ganti satu konfigurasi — pelajaran dari episode #43 soal fallback dan observability.
- Uji ulang tiap rilis besar. Papan peringkat berubah dalam hitungan hari setelah model baru rilis; eval saya sendiri yang jadi jangkar.
Yang saya bawa pulang
Memilih model dengan tenang berarti berhenti percaya satu angka. Arena memberi sinyal preferensi manusia yang jujur tapi tidak spesifik domain saya; benchmark publik memberi ukuran tapi bisa terkontaminasi; dan eval sendiri — meski paling lambat dibuat — adalah satu-satunya yang benar-benar menjawab apakah model itu layak masuk produk saya. Bagi saya, memilih model kini terasa seperti memilih library: baca changelog, lihat komunitas, lalu buktikan sendiri di kasus saya sendiri.
Sumber
- Arena (resmi): Chatbot Arena — Benchmarking LLMs in the Wild with Elo Ratings & LMArena is now Arena (28 Jan 2026)
- Paper asli Chatbot Arena: Chatbot Arena: An Open Platform for Evaluating LLMs by Pairwise Comparison (arXiv:2403.04132, 2024)
- Kontaminasi benchmark: TCG-Bench (EACL Findings 2026) yang merangkum statistik kontaminasi MMLU/ARC/HumanEval/TriviaQA
- Skor jenuh & benchmark game: GAMEBoT (arXiv:2412.13602, 2025)
- Manipulasi ranking: Improving Your Model Ranking on Chatbot Arena by Vote Rigging (arXiv:2501.17858, 2025)
- Blog LMSYS: Announcing a New Site for Chatbot Arena (Sep 2024)
Komentar Terbaru