Di episode #31 kita sudah memutuskan kapan fine-tuning itu worth it. Episode ini saya lanjutkan ke praktiknya: bagaimana cara fine-tuning LLM di GPU consumer dengan biaya yang masuk akal. Jawabannya ada di dua kata: LoRA dan QLoRA. Saya baru benar-benar paham konsepnya setelah mencoba sendiri, dan ternyata lebih sederhana dari yang saya bayangkan.
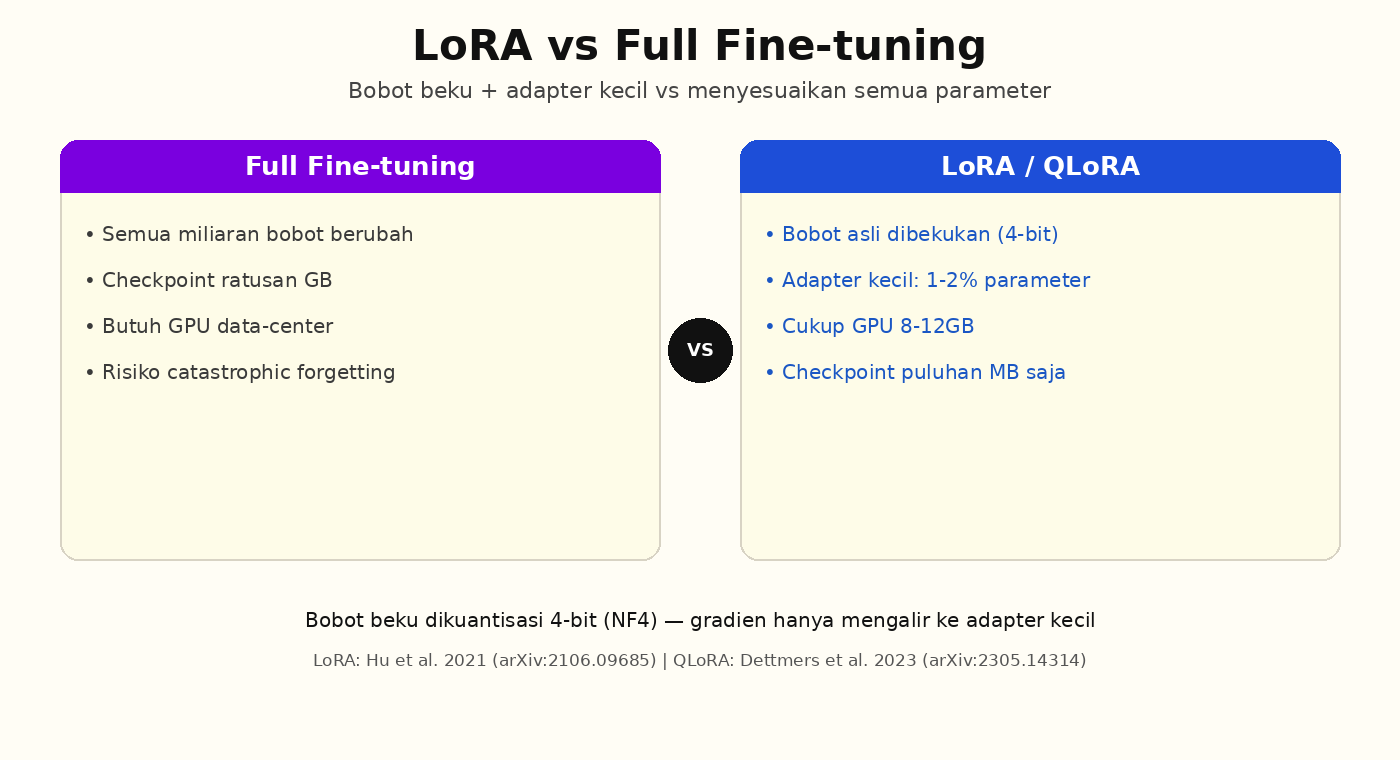
LoRA: adapter kecil di samping bobot beku
Fine-tuning penuh (full fine-tuning) artinya menyesuaikan SEMUA parameter model. Model 7B parameter berarti 7 miliar bobot yang ikut berubah — butuh GPU besar dan penyimpanan checkpoint berlipat. LoRA (Low-Rank Adaptation, Hu et al. 2021) mengubah asumsi itu: bobot asli DIBEKUKAN, lalu kita tambahkan dua matriks kecil (adapter A dan B) di sampingnya yang memang ikut dilatih. Ide matematikanya: update bobot selama fine-tuning sebenarnya punya “rank” rendah — perubahannya tidak benar-benar butuh ribuan dimensi penuh, cukup faktorisasi matriks berukuran kecil.
Bagi saya sebagai programmer, analogi paling mudah: LoRA itu seperti monkey-patch. Kode asli (bobot model) tidak disentuh, kita hanya menambah file patch kecil yang berisi perubahan. Karena adapter-nya kecil (biasanya hanya 1–2% dari total parameter), checkpoint fine-tuning bisa cuma puluhan MB dibanding puluhan GB. Satu model dasar bisa dipakai dengan banyak adapter berbeda — tinggal tukar patch-nya.
Dua hyperparameter yang paling sering diutak-atik: rank (r) dan alpha. Rank menentukan seberapa besar kapasitas adapter — r=8 sampai r=64 adalah rentang umum untuk tugas bahasa; makin kompleks tugas, makin besar r yang dibutuhkan. Alpha mengatur skala kontribusi adapter terhadap keluaran model. Yang juga penting: target modules, yaitu layer mana yang dipasangi adapter. Untuk LLM modern biasanya semua layer attention (q_proj, k_proj, v_proj, o_proj), kadang ditambah layer MLP.
QLoRA: menekan bobot dasar ke 4-bit
LoRA sudah murah, tapi bobot model dasar tetap harus muat di VRAM. QLoRA (Dettmers et al. 2023) menekan ini lebih jauh: bobot dasar dikuantisasi ke 4-bit SEBELUM dilatih, gradien dilewatkan melewati model beku 4-bit itu menuju adapter LoRA yang tetap FP16/BF16. Paper aslinya membuktikan 65B model bisa di-fine-tune di satu GPU 48GB dengan kualitas mendekati full fine-tuning 16-bit.
Tiga inovasi kunci QLoRA yang perlu saya catat: NF4 (4-bit NormalFloat) — format kuantisasi yang dirancang khusus untuk distribusi bobot berdistribusi normal, bukan kuantisasi uniform biasa; double quantization — parameter kuantisasi itu sendiri juga dikuantisasi untuk menghemat memori lagi; dan paged optimizers — optimizer bisa “berpindah” memori ke RAM kalau VRAM sempit, mencegah OOM saat spike memori. Hasil praktisnya: GPU 8–12GB seperti RTX 3060/4060 sudah cukup untuk fine-tuning model 7B–8B.
Langkah praktisnya
Ekosistemnya sudah matang berkat Hugging Face: library PEFT untuk LoRA/QLoRA, TRL untuk training loop (SFTTrainer), bitsandbytes untuk kuantisasi 4-bit, plus Unsloth yang menurut dokumentasinya mempercepat training hingga 2x dengan VRAM lebih hemat. Konfigurasi intinya kira-kira seperti ini:
from peft import LoraConfig
from transformers import BitsAndBytesConfig

# 1. Kuantisasi 4-bit untuk bobot dasar (QLoRA)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",            # NormalFloat4 dari paper QLoRA
    bnb_4bit_compute_dtype="bfloat16",
    bnb_4bit_use_double_quant=True,        # double quantization
)

# 2. Config adapter LoRA
lora_config = LoraConfig(
    r=16,                                  # rank adapter
    lora_alpha=32,                         # skala alpha (umum: 2x rank)
    target_modules=["q_proj", "v_proj"],   # layer yang dipasangi adapter
    lora_dropout=0.05,
    task_type="CAUSAL_LM",
)
Setelah training selesai, adapter disimpan sebagai file kecil. Untuk dipakai inference, adapter bisa di-merge ke bobot dasar (hasilnya model penuh) atau dipasang-buka sesuai kebutuhan. Kalau ingin menjalankannya lokal, ada converter ke format GGUF — nyambung ke pembahasan episode #24.
Yang saya pelajari dari mencoba sendiri
- Dataset lebih penting dari hyperparameter. Seratus contoh berkualitas (format konsisten, contoh benar-benar benar) mengalahkan sepuluh ribu contoh asal kumpul. Ini mengingatkan saya: eval dari episode #30 tetap wajib — fine-tuning tanpa eval cuma nebak.
- Fine-tuning bukan injeksi pengetahuan. Model tidak “tahu” fakta baru dari dataset — yang terbentuk lebih ke gaya, format, dan pola respons. Kalau butuh fakta terkini, RAG masih jawabannya (lihat lagi keputusan di episode #31).
- Learning rate kecil. Karena bobot dasar beku dan yang dilatih hanya adapter, LR besar justru bikin adapter tidak stabil. Saya mulai dari 2e-4 lalu turun.
- Cek loss curve, bukan cuma lihat selesai. Training yang terlihat sukses tapi loss datar biasanya berarti dataset bermasalah atau target modules salah.
Kesimpulan catatan saya: LoRA/QLoRA menurunkan pintu masuk fine-tuning dari “butuh cluster GPU” menjadi “cukup satu GPU gaming”. Yang tetap tidak turun adalah disiplinnya — data yang hati-hati dan eval yang jujur. Di episode berikutnya kita dalami bahan bakarnya: embedding dan vector database.
Sumber
- LoRA: Low-Rank Adaptation of Large Language Models — arXiv:2106.09685 (Hu dkk., 2021)
- QLoRA: Efficient Finetuning of Quantized LLMs — arXiv:2305.14314 (Dettmers dkk., 2023)
- Hugging Face PEFT documentation — huggingface.co/docs/peft
- Hugging Face TRL (SFTTrainer) — huggingface.co/docs/trl
- Unsloth (GitHub) — github.com/unslothai/unsloth
Komentar Terbaru