Sampai minggu lalu saya kira voice assistant itu cuma chatbot yang suaranya di-output ke speaker. Setelah saya coba merangkai sendiri pipeline-nya, saya baru sadar: voice itu masalah yang sama sekali berbeda. Di teks, saya bisa menunggu tiga detik tanpa drama. Di suara, jeda tiga detik terasa seperti lawan bicara sudah pergi. Hari ini saya catat apa yang saya pelajari soal Voice AI: komponennya, arsitekturnya, dan kenapa latensi adalah musuh utamanya.
Kenapa Voice Beda dari Chatbot Teks
Di episode #26 kita bahas bahwa agent itu loop perceive-reason-act. Voice hanya mengganti “perceive” dan “act” dengan media suara, tapi konsekuensinya besar. Percakapan manusia punya ritme: seseorang berhenti bicara sekitar 200–300 milidetik sebelum lawan bicara merespons. Kalau sistem kita lebih lambat dari itu, terjadilah dua hal yang merusak pengalaman: diam canggung, atau sistem memotong (barge-in) di saat lawan bicara belum selesai. Ini berarti bagi saya: mendesain voice agent itu 50% masalah machine learning, 50% masalah sistem real-time.
ASR — Whisper dan Keluarganya
Speech-to-text konvensional itu repot: butuh pihak ketiga (CMU Sphinx misalnya), banyak grammar rule, dan begitu ada noise pabrik atau aksen, hasilnya berantakan. Whisper dari OpenAI (rilis Desember 2022, paper Robust Speech Recognition via Large-Scale Weak Supervision) mengubah cara saya melihat ini: model transformer yang dilatih pada 55 juta pasang audio-teks dari internet — data berlabel lemah, bukan dataset bersih buatan lab. Hasilnya justru lebih robust terhadap noise, aksen, dan campur bahasa. Saya selalu ingat analogi ini: Whisper itu seperti parser yang dilatih dengan seluruh isi internet, bukan dengan grammar buatan sendiri — sedikit kotor datanya, tapi generalisasinya luar biasa.
Roadmap versinya juga menarik saya ikuti: large-v2 (Desember 2022), large-v3 (November 2023), lalu large-v3-turbo (September 2024) yang memangkas decoder dari 32 layer jadi 4 — sekitar 8 kali lebih cepat dengan akurasi yang menurut saya masih sangat cukup untuk percakapan. Di lapangan saya pakai faster-whisper (CTranslate2) atau whisper.cpp kalau mau jalan di laptop sendiri, plus distil-whisper kalau mau lebih hemat lagi. Ini berarti buat saya: ASR bukan lagi bottleneck yang mahal.
TTS Modern — Suara yang Tidak Robot
Text-to-speech zaman dulu (concatenative/parametrik) terdengar kaku karena potongan rekaman disambung-sambung. TTS neural modern memperlakukan tugas ini seperti generative modeling — mirip filosofi yang kita lihat di episode #35 soal multimodal. Pilihan yang saya temukan: layanan managed seperti OpenAI TTS dan ElevenLabs, atau yang self-host seperti Kokoro (model 82M parameter, sangat ringan), Chatterbox dari Resemble AI, CosyVoice dari Alibaba, XTTS v2, dan Piper untuk yang butuh CPU-only super cepat.
Trik teknis yang menurut saya paling penting: TTS modern bisa streaming. Time-to-first-audio modern ada di kisaran 75–200 milidetik, artinya audio mulai mengalir sebelum kalimat selesai dirangkai — sama seperti streaming response di LLM. Ini berarti bagi saya: jangan pernah menunggu seluruh jawaban jadi sebelum mulai bicara, itu pemborosan waktu yang tidak perlu.
VAD & Turn-Taking — Bagian yang Sering Dilupakan
Sebelum Whisper bekerja, seseorang harus memutuskan: apakah memang sedang ada orang yang bicara, dan kapan dia selesai. Ini pekerjaan Voice Activity Detection (VAD). Di praktik yang saya baca, Silero VAD jadi favorit karena ringan dan bisa jalan real-time di CPU. Buat saya yang biasa kerja di web, analoginya gampang: VAD itu event listener untuk suara, dan turn detection itu interrupt handler. Barge-in (user memotong jawaban bot) harus ditangani eksplisit — kalau tidak, bot akan terus bicara di atas suara user dan percakapannya hancur.
Dua Jalur Arsitektur
Setelah merangkai prototipe, saya melihat dua jalur yang berbeda:
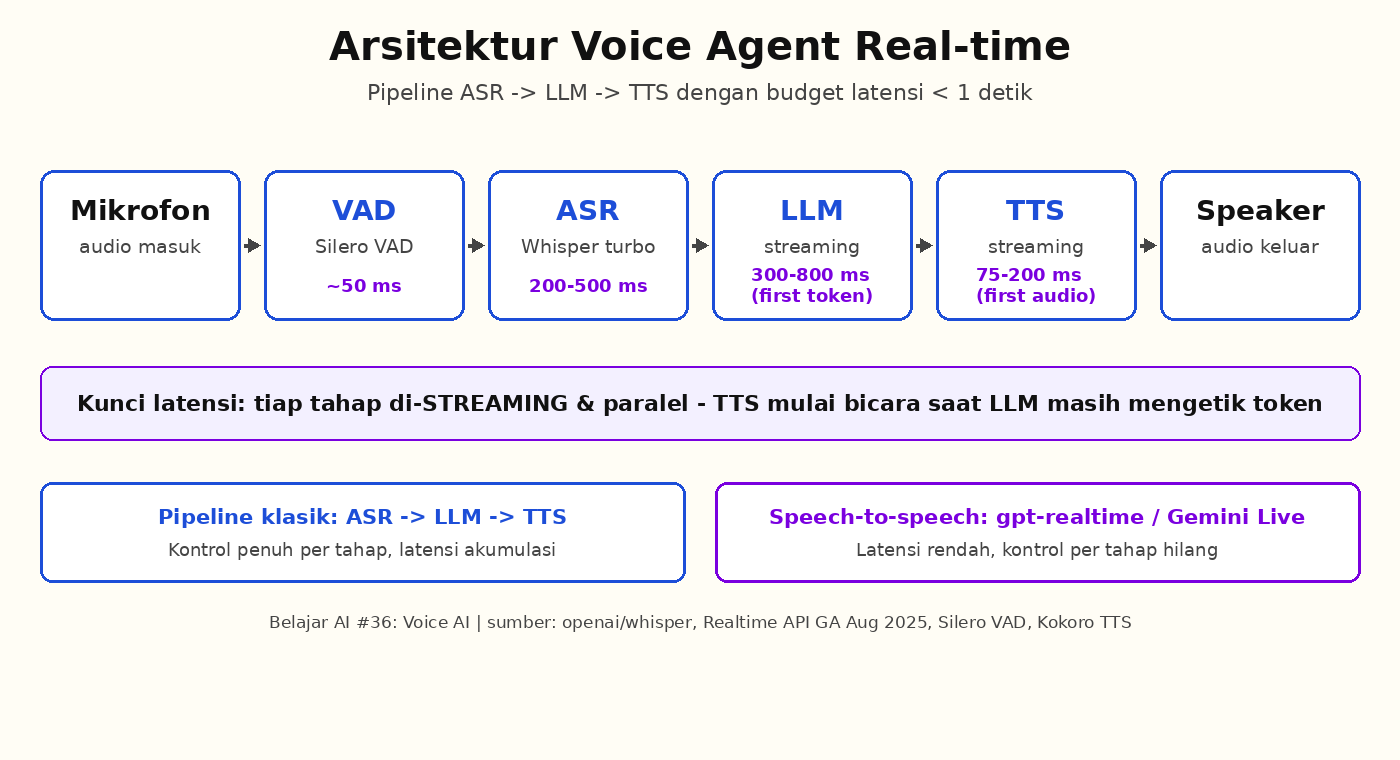
- Pipeline klasik ASR → LLM → TTS. Tiga komponen terpisah, masing-masing bisa diganti dan didebug sendiri. Kekurangannya: latensi akumulasi, dan intonasi tidak selalu nyambung dengan konteks kalimat.
- Speech-to-speech. Satu model end-to-end menerima dan mengeluarkan audio. Contoh nyata: OpenAI Realtime API yang keluar dari beta jadi GA pada 28 Agustus 2025 dengan model gpt-realtime (dukungan MCP, image input, bahkan SIP untuk telepon), dan Gemini Live di kubu Google. Latensinya lebih rendah, tapi saya kehilangan kontrol per-tahap.
Keputusan yang saya ambil di prototipe: pakai pipeline klasik dulu supaya saya bisa mengukur tiap tahap. Baru setelah paham bottleneck-nya, pertimbangkan jalur speech-to-speech. Karena agent-nya juga memanggil tools (lihat episode #27 soal function calling), pipeline klasik membuat saya bisa menampilkan “sedang memeriksa database…” ke user selama model bekerja — hal yang sulit dilakukan di model end-to-end.
Latensi — Musuh Utama
Budget latensi yang saya pakai sebagai target: respons di bawah satu detik biar terasa percakapan normal. Kalau diurai kasar, tiap tahap menyumbang begini:
| Tahap | Latensi tipikal | Catatan |
|---|---|---|
| VAD / turn detect | ~50 ms | Silero VAD di CPU |
| ASR (Whisper turbo, streaming) | 200–500 ms | GPU jauh lebih cepat dari CPU |
| LLM time-to-first-token | 300–800 ms | model kecil + streaming |
| TTS time-to-first-audio | 75–200 ms | streaming wajib |
Serangkaian angka itu kalau dijumlahkan bisa melewati satu detik dengan mudah. Pola optimasi yang saya temukan familiar bagi siapa pun yang pernah optimasi query database: jalankan tahap secara streaming dan paralel (mulai TTS ketika LLM masih menghasilkan token), pakai model kecil untuk tugas sederhana, cache respons untuk pertanyaan berulang, dan ukur dulu sebelum mengoptimasi. Saya belajar satu hal keras kepala di sini: tanpa instrumentasi per-tahap, mengurangi latensi itu cuma tebak-tebakan.
Mulai dari Mana
Kalau mau coba sendiri, dua jalur yang menurut saya realistis. Jalur managed: Realtime API atau Gemini Live — cepat jadi, bayar per menit. Jalur self-host: faster-whisper + Silero VAD + Kokoro/Piper, semuanya muat di mesin kecil dengan GPU consumer (atau bahkan CPU untuk model kecil). Saya memilih jalur self-host dulu karena ingin melihat sendiri bagaimana tiap komponen bekerja — sesuai kebiasaan saya belajar dengan membongkar, bukan cuma memakai.
Yang paling saya ambil dari episode ini: voice AI bukan sekadar “chatbot + TTS”. Ia adalah sistem real-time di mana ritme percakapan adalah requirement fungsional, bukan sekadar UX. Latensi yang tadinya saya anggap hal teknis, di sini langsung menentukan apakah produknya terasa hidup atau tidak.
Sumber
- Whisper (OpenAI) — paper & kode: github.com/openai/whisper — arXiv:2212.04356 (Des 2022)
- Whisper large-v3-turbo release note (Sep 2024): github.com/openai/whisper/discussions/2363
- OpenAI Realtime API GA + gpt-realtime (28 Agu 2025): openai.com
- Silero VAD: github.com/snakers4/silero-vad
- Kokoro TTS: huggingface.co/hexgrad/Kokoro-82M
- Piper (TTS ringan CPU): github.com/rhasspy/piper
- Introl — Voice AI Infrastructure guide 2025 (angka streaming TTS 75–200 ms): introl.com
Komentar Terbaru