Hari ini saya mulai seri baru: Belajar AI. Sebagai programmer yang sehari-hari menulis kode, saya merasa perlu memahami teori di baliknya — bukan sekadar memakai API. Dan saya memutuskan mulai dari awal: sejarah. Bukan karena nostalgia, tapi karena sejarah menjelaskan satu hal yang sering membingungkan saya: kenapa AI sempat “mati” dua kali, lalu bangkit lagi dan sekarang ada di mana-mana. Mari kita telusuri.
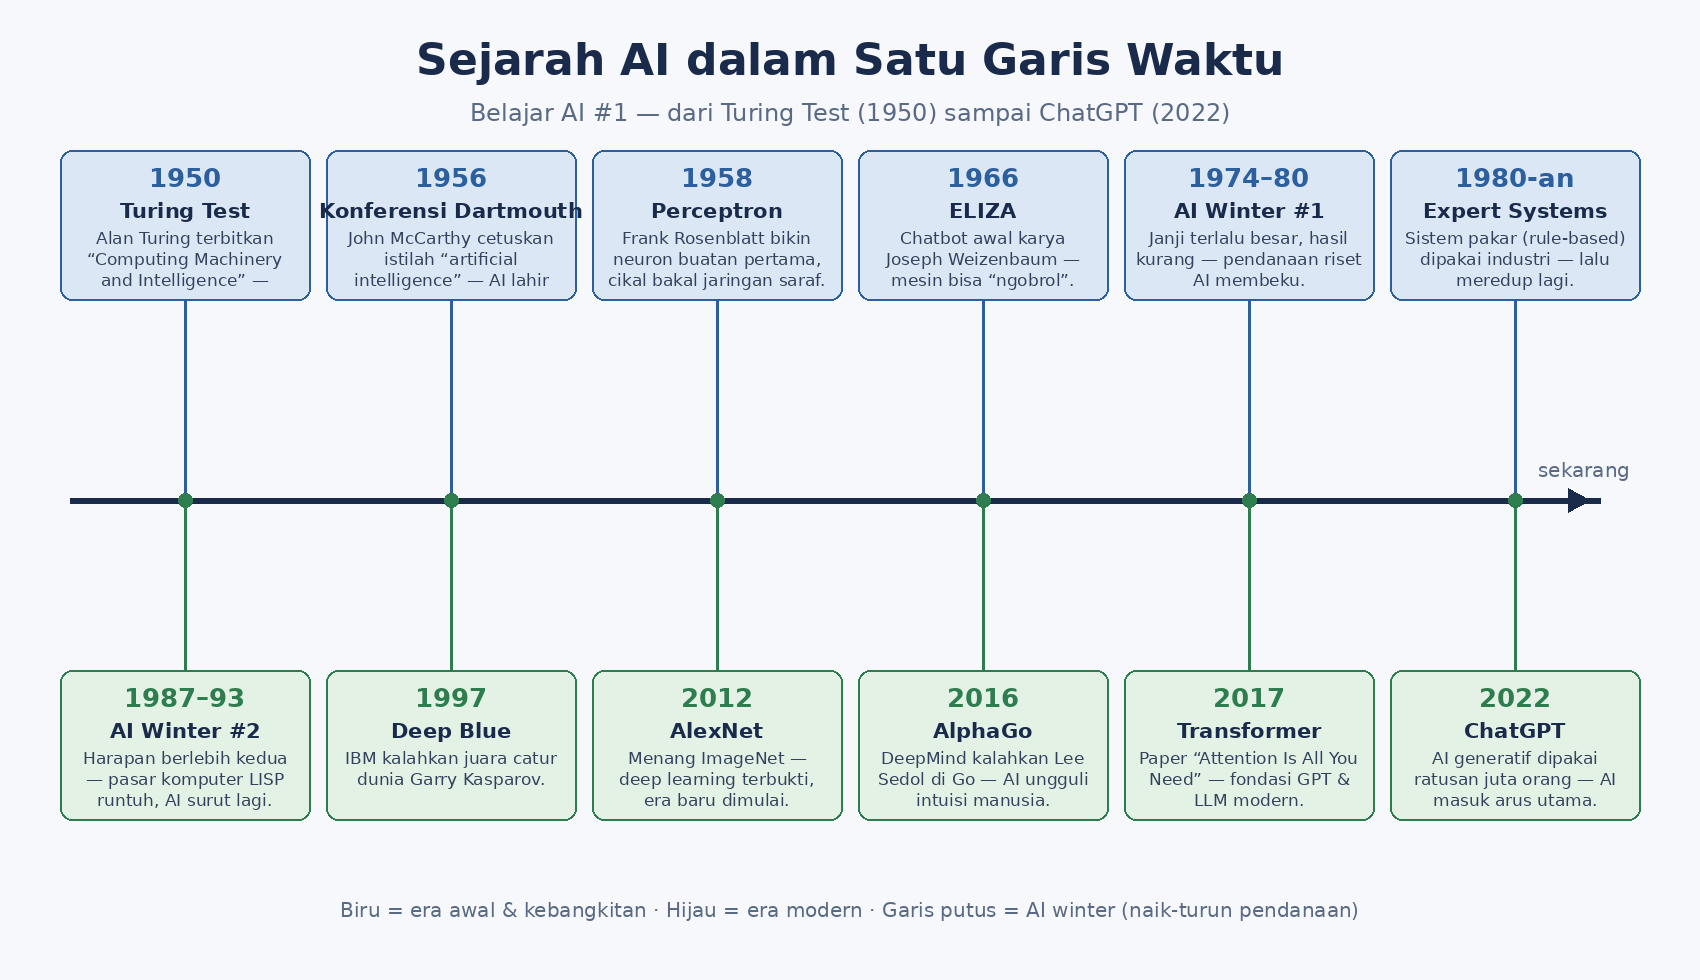
1950: Turing Test — titik tolak
Alan Turing, matematikawan asal Inggris, menerbitkan paper berjudul “Computing Machinery and Intelligence” di jurnal Mind tahun 1950. Pertanyaannya sederhana: can machines think? Tapi karena “berpikir” terlalu kabur untuk diuji, Turing menggantinya dengan permainan imitasi: seorang pemeriksa mengobrol dengan mesin dan manusia melalui teks. Kalau pemeriksa tidak bisa membedakan mana mesin mana manusia, mesin itu dianggap lolos uji kecerdasan.
Dari sudut pandang programmer, Turing Test itu seperti unit test yang kasar: kita tidak mengukur cara kerja dalamnya, hanya hasil luarnya. Mesin boleh diimplementasikan dengan cara apa pun — yang penting outputnya tidak bisa dibedakan dari manusia. Konsep ini penting karena menanamkan pola pikir “kecerdasan bisa dinilai dari perilaku”, bukan dari jiwa atau kesadaran.
1956: Konferensi Dartmouth — lahirnya nama “AI”
Enam tahun kemudian, John McCarthy mengusulkan sebuah workshop musim panas di Dartmouth College, Amerika Serikat. Para pesertanya adalah tokoh yang kelak menjadi bapak pendiri AI: McCarthy, Marvin Minsky, Claude Shannon, dan Nathaniel Rochester. Di konferensi inilah istilah artificial intelligence pertama kali dicetuskan, dan AI resmi menjadi bidang riset.
Yang menarik: optimisme saat itu sangat tinggi. Mereka memperkirakan masalah AI bisa diselesaikan dalam satu generasi. Setelah konferensi, muncul beberapa hasil awal yang menjanjikan — Frank Rosenblatt membuat perceptron (neuron buatan sederhana) tahun 1958, dan Joseph Weizenbaum membuat chatbot ELIZA tahun 1966 yang bisa “ngobrol” ala terapis. Tapi dari kejauhan, saya melihat pola yang sama dengan hype teknologi sekarang: ekspektasi melampaui kenyataan.
Dua musim dingin: AI winter
Janji besar tanpa hasil yang konsisten membuat pendanaan riset AI membeku dua kali. Para sejarawan menyebut periode ini AI winter:
- 1974–1980 (AI winter pertama): laporan Lighthill di Inggris tahun 1973 mengkritik habis-habisan capaian AI, pendanaan pemerintah dan industri menyusut drastis.
- 1980-an (kebangkitan sistem pakar): expert systems — program berisi aturan if-then yang ditulis manual oleh ahli — dipakai di industri, misalnya untuk diagnosis dan konfigurasi. Populer, tapi mahal dan rapuh: aturan tidak bisa menangani kasus di luar yang tertulis.
- 1987–1993 (AI winter kedua): pasar komputer LISP (bahasa favorit riset AI) runtuh, proyek sistem pakar ditinggalkan satu per satu.
Bagi saya ini pelajaran berharga: AI berbasis aturan yang ditulis tangan tidak pernah benar-benar “belajar”. Ia sekuat pengetahuan yang dimasukkan manusia, dan rapuh di luar domain itu. Paradigma inilah yang akhirnya digantikan oleh machine learning.
Kebangkitan: machine learning & deep learning
Alih-alih menulis aturan secara manual, machine learning membuat model belajar dari data. Beberapa tonggak yang saya catat:
- 1997 — Deep Blue: komputer IBM mengalahkan juara catur dunia Garry Kasparov. Masih berbasis pencarian dan aturan, tapi momen penting: AI mengalahkan manusia di game populer.
- 2012 — AlexNet: jaringan saraf konvolusional karya Alex Krizhevsky, Ilya Sutskever, dan Geoffrey Hinton menang telak di kompetisi ImageNet. Inilah momen deep learning “resmi” naik daun — berkat data besar dan GPU.
- 2016 — AlphaGo: sistem DeepMind mengalahkan Lee Sedol di permainan Go, yang selama ini dianggap terlalu kompleks untuk diselesaikan dengan brute force.
- 2017 — Transformer: paper “Attention Is All You Need” memperkenalkan arsitektur transformer, yang kelak menjadi fondasi GPT dan semua LLM modern.
Deep learning revolution: dari AlexNet ke Transformer
Saya perlu mengulik lebih dalam bagaimana revolusi ini terjadi, karena dari luar terlihat seperti “tiba-tiba berhasil”, padahal ada rantai inovasi bertahun-tahun.
AlexNet (2012) bukan sekadar menang kompetisi. Yang berubah adalah kombinasi tiga hal: dataset ImageNet berisi 14 juta gambar berlabel, GPU NVIDIA yang mempercepat perkalian matriks ratusan kali lipat, dan teknik seperti dropout serta ReLU activation yang mencegah overfitting. Saya bayangkan ini seperti punya mesin yang sama, tapi dengan bahan bakar 100x lebih efisien.
ResNet (2015) menyelesaikan masalah berikutnya: jaringan yang terlalu dalam justru performanya turun. Kaiming He dan tim dari Microsoft memperkenalkan residual connections — shortcut yang membiarkan gradien mengalir melewati lapisan-lapisan tanpa pudar. Analogi untuk programmer: seperti error handling yang menangkap exception di setiap level, bukan hanya di satu tempat. Tanpa ResNet, kita tidak akan punya jaringan ratusan atau ribuan lapisan.
Transformer (2017) benar-benar mengubah segalanya. Sebelum transformer, model bahasa Sequential Processing (RNN, LSTM) memroses teks kata demi kata — lambat dan sulit menangkap konteks jarak jauh. Transformer memperkenalkan self-attention: mekanisme yang membiarkan setiap kata “melihat” semua kata lain sekaligus, paralel. Dari sudut pandang arsitektur, ini seperti beralih dari serial I/O ke parallel processing — pemahaman yang sangat dekat dengan hati seorang programmer.
2022–sekarang: AI generatif arus utama
ChatGPT dirilis November 2022 dan dipakai ratusan juta orang dalam hitungan bulan. Yang tadinya riset laboratorium menjadi produk harian: menulis, coding, menggambar, menganalisis. Sejarah tidak berhenti di sini — tapi untuk seri ini, 2022 adalah titik awal era yang sedang kita jalani.
Evolusi LLM: dari GPT-2 ke multi-model era
Saya merasa perlu memetakan evolusi LLM karena ini membantu saya memahami seberapa cepat bidang ini bergerak. Dalam kurun tujuh tahun terakhir, kapabilitas model bahasa berubah secara eksponensial:
GPT-2 (2019) dirilis OpenAI dengan 1.5 miliar parameter — sudah cukup untuk menghasilkan teks yang meyakinkan, tapi masih sering menyimpang dari topik. Saat itu OpenAI ragu merilis model penuh karena khawatir disalahgunakan untuk pembuatan hoaks. Saya sendiri pertama kali merasakan “ajaibnya” AI generatif di era ini: cukup berikan satu kalimat pembuka, lalu biarkan model melanjutkan.
GPT-3 (2020) melompat ke 175 miliar parameter. Ini bukan sekadar skala lebih besar — ada kemampuan few-shot learning yang baru: tanpa fine-tuning, model bisa mengikuti instruksi dari beberapa contoh dalam prompt. Saya ingat momen pertama kali memakai GPT-3 API: memberikan instruksi dalam bahasa natural dan model langsung mengerti. Rasanya seperti chatting dengan rekan kerja yang sangat terampil, meski kadang “hallucinate” dengan meyakinkan.
ChatGPT (2022) pada dasarnya adalah GPT-3.5 dengan RLHF (Reinforcement Learning from Human Feedback). Yang berubah bukan kecerdasan mentah, tapi kemampuan untuk menjawab dengan benar dan membantu. RLHF memanusiakan model — menambahkan lapisan “tahu kapan harus berkata tidak tahu” dan mengikuti petunjuk pengguna.
GPT-4 (2023) membawa kemampuan multimodal: bisa membaca gambar, menangani konteks lebih panjang, dan mengurangi hallucination secara signifikan. Saya menggunakannya untuk review kode dan dokumentasi — kemampuannya memahami konteks proyek utuh terasa seperti lompatan kualitas dari GPT-3.5.
Claude (Anthropic) dan Gemini (Google) memperluar persaingan. Claude dikenal karena safety dan kemampuan menangani konteks sangat panjang — berguna untuk saya ketika perlu menganalisis codebase besar. Gemini mengintegrasikan search Google dan multimodal secara native. Pesaing banyak, dan ini bagus: kompetisi memacu inovasi lebih cepat daripada monopoli.
Tabel era AI: ringkasan visual
Untuk memperjelas, saya susun tabel ringkasan periode-periode penting sejarah AI:
| Era | Tahun | Breakthrough | Dampak |
|---|---|---|---|
| Foundations | 1950–1956 | Turing Test, Konferensi Dartmouth | AI menjadi bidang riset resmi |
| Early Optimism | 1958–1966 | Perceptron, ELIZA | Proof of concept awal |
| AI Winter I | 1974–1980 | Lighthill Report | Pendanaan membeku |
| Expert Systems | 1980–1987 | Sistem pakar industri | Adopsi komersial pertama |
| AI Winter II | 1987–1993 | Runtuhnya pasar LISP | Krisis kepercayaan kedua |
| ML Renaissance | 1997–2011 | Deep Blue, SVM, Random Forest | Statistical learning dominan |
| Deep Learning | 2012–2017 | AlexNet, ResNet, Transformer | Neural network jadi standar |
| LLM Era | 2018–2022 | GPT-2, GPT-3, ChatGPT | AI generatif arus utama |
| Multi-Model | 2023–sekarang | GPT-4, Claude, Gemini | Persaingan multi-vendor |
AI di Indonesia: potret lokal
Sebagai programmer Indonesia, saya juga penasaran bagaimana perkembangan AI terasa di lingkungan lokal. Beberapa hal yang saya catat dari riset dan pengalaman pribadi:
- Komunitas: komunitas AI di Indonesia tumbuh pesat. Group seperti AI Indonesia (Telegram), meetup di Jakarta dan Bandung, serta konferensi seperti AI Conference Indonesia menjadi tempat bertukar pengetahuan. Saya sendiri belajar banyak dari diskusi komunitas ini.
- Startup & industri: beberapa startup lokal seperti Nodeflux (computer vision), Kata.ai (NLP), dan GoPay memanfaatkan AI untuk solusi spesifik pasar Indonesia — misalnya OCR untuk KTP, chatbot berbahasa lokal, dan fraud detection.
- Regulasi: pemerintah Indonesia mulai menyusun regulasi AI, termasuk pedoman etika dan tata kelola. Ini penting karena AI yang tidak diatur bisa memperburuk ketimpangan digital yang sudah ada.
- Tantangan lokal: ketersediaan dataset berbahasa Indonesia masih terbatas, bandwidth internet tidak merata, dan talenta AI bersertifikat masih langka. Ini justru menjadi peluang besar untuk programmer lokal.
Catatan programmer: mengingat lewat data
Sebagai programmer, cara paling natural buat saya mengingat sejarah ini adalah menjadikannya data — list pasangan (tahun, peristiwa):
sejarah = [
    (1950, "Turing Test"),
    (1956, "Konferensi Dartmouth"),
    (1974, "AI winter pertama"),
    (1987, "AI winter kedua"),
    (1997, "Deep Blue kalahkan Kasparov"),
    (2012, "AlexNet menang ImageNet"),
    (2015, "ResNet: residual connections"),
    (2017, "Paper Transformer"),
    (2019, "GPT-2 rilis"),
    (2020, "GPT-3: 175B parameter"),
    (2022, "ChatGPT rilis"),
    (2023, "GPT-4, Claude, Gemini"),
]
for tahun, peristiwa in sejarah:
    print(f"{tahun}: {peristiwa}")
Dari data ini saya menangkap pola besar: ide neural network sebenarnya sudah ada sejak 1958 (perceptron), tapi baru meledak tahun 2012. Yang berubah bukan teorinya, melainkan dua bahan bakar: data besar dan komputasi murah (GPU). Jadi ketika orang bilang “AI baru”, yang baru sebenarnya adalah skala, bukan konsep dasarnya.
Prediksi masa depan: AGI dan dampaknya
Saya sadar memprediksi masa depan AI itu berisiko — banyak prediksi sebelumnya yang meleset. Tapi setidaknya ada beberapa tren yang tampak jelas dari data sejarah ini:
AGI (Artificial General Intelligence) — AI yang setara atau melampaui kecerdasan manusia umum — masih jadi perdebatan. Beberapa peneliti seperti Yann LeCun memperkirakan kita masih puluhan tahun jauhnya. Yang lain seperti Sam Altman (CEO OpenAI) lebih optimis: beberapa tahun saja. Saya sendiri, dari sudut pandang programmer praktisi, melihat bahwa kemampuan spesifik AI sudah melampaui manusia di banyak domain — tapi generalisasi penuh masih sulit karena AI tidak punya pengalaman tubuh dan interaksi dunia nyata.
Dampak ke pekerjaan adalah pertanyaan paling mendesak. Dari pengalaman saya, AI sudah mengubah cara kerja: coding assistant seperti Copilot mempercepat penulisan boilerplate, ChatGPT menjadi pencarian interaktif, dan model generatif mempercepat prototyping. Yang saya prediksi akan terjadi: bukan penggantian massal pekerja, melainkan pembagian ulang skill — programmer yang menguasai AI akan jauh lebih produktif dari yang tidak. Analoginya sama seperti pengguna spreadsheet yang produktivitasnya berbeda 10x dari yang pakai kalkulator.
Mengapa saya mulai belajar AI
Catatan personal untuk menutup seri pertama ini: saya mulai belajar AI bukan karena FOMO, tapi karena rasa ingin tahu yang tulus. Sebagai programmer selama bertahun-tahun, saya merasa seperti tukang yang menggunakan mesin tanpa memahami prinsip kerjanya. Ketika pertama kali saya melihat neural network sederhana mengenali angka tulisan tangan di tutorial MNIST, ada momen “aha!” yang membuat saya sadar: ini bukan sihir — ini matematika yang elegan. Dan setiap kali saya memahami satu konsep baru, saya merasa toolkit saya sebagai programmer makin lengkap. Seri Belajar AI ini adalah catatan perjalanan itu — dan saya harap bermanfaat untuk sesama programmer yang merasakan hal yang sama.
Komentar Terbaru