Sejauh ini di Season 2 kita banyak membahas LLM yang bekerja dengan teks: function calling (#27), guardrails format (#34), sampai RAG (#31). Tapi manusia tidak bekerja cuma dengan teks — kita lihat layar, dengar suara, baca tabel. Episode #35 ini saya catat tentang multimodal AI: model yang menerima lebih dari satu jenis input (modalitas) dan menghasilkan output yang bisa juga lebih dari sekadar teks.
Apa itu multimodal?
Modalitas = jenis data. Teks itu satu modalitas. Gambar, audio, video, PDF berisi campuran teks dan gambar juga modalitas. Model unimodal cuma paham satu jenis; model multimodal memahami beberapa sekaligus di dalam satu model, bukan dilempar antar model berbeda.
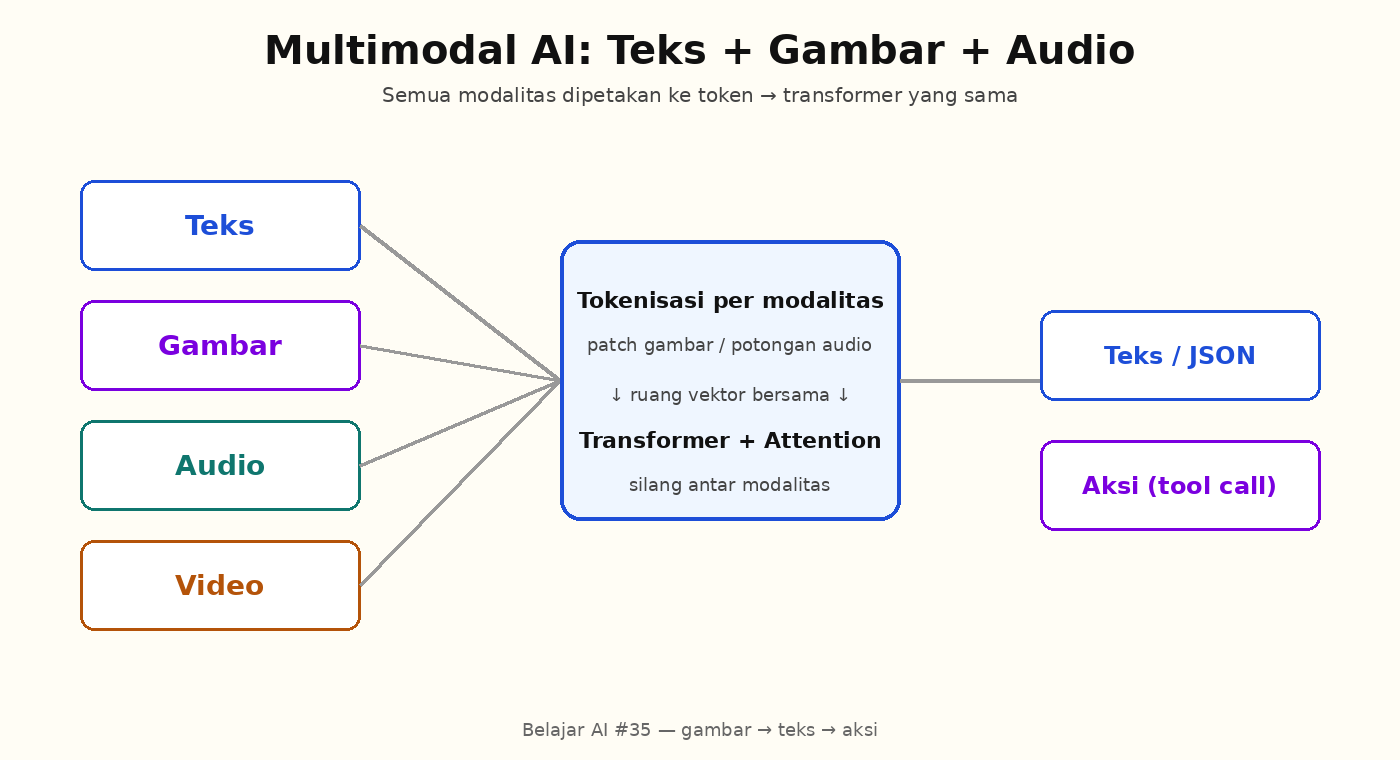
Cara kerja kasarnya mirip dengan embedding yang sudah kita bahas di episode #33: tiap modalitas dipotong menjadi “token”-nya sendiri lalu dipetakan ke ruang vektor yang sama. Patch gambar 16×16 piksel menjadi beberapa visual token; potongan audio menjadi token audio. Setelah itu transformer memprosesnya seperti teks — attention bisa melihat silang antar modalitas. Jadi “lihat gambar” secara teknis tetap soal sequence token, hanya sumbernya bukan huruf.
Peta model multimodal 2024–2026
| Model | Rilis | Input | Catatan |
|---|---|---|---|
| GPT-4o | Mei 2024 | Teks, gambar, audio, video | OpenAI; end-to-end audio, bukan pipeline terpisah |
| Gemini 1.5 / 2.x | 2024–2025 | Teks, gambar, audio, video, PDF | Google; context window sangat panjang (1 juta+ token) |
| Llama 3.2 Vision | Sep 2024 | Teks + gambar | Meta; open weight, 11B & 90B, adapter cross-attention di atas Llama 3.1 |
| Qwen2-VL / Qwen2.5-VL | 2024–2025 | Teks + gambar + video | Alibaba; open weight, populer untuk dipakai lokal |
Catatan jujur: tabel ini saya susun dari pengumuman rilis resmi masing-masing perusahaan; versi “2.x” Gemini dan turunan Qwen berubah cepat, jadi sebelum memilih model untuk proyek, cek rilis terbaru di halaman resminya — jangan percaya angka di episode ini untuk keputusan production bulan depan.
Pola nyata: gambar → teks → aksi
Yang paling sering saya temui di pemakaian nyata bukan “tanya gambar”, tapi rantai: gambar → deskripsi atau struktur → aksi. Contoh konkret untuk programmer:
- Screenshot error → solusi. Kirim screenshot stack trace, model membaca konteks lalu memberi diagnosis. Sama dengan copy-paste teks tapi tanpa repot seleksi teks.
- Mockup desain → kode HTML/CSS. Desainer memberi gambar, agent mengubahnya jadi markup — mirip alur tool use di episode #27, hanya inputnya visual.
- Invoice atau faktur → JSON. Gabungan dengan episode #34: minta structured output, lalu validasi dengan JSON schema. Kalau model salah baca angka, minimal formatnya benar dan gagal cepat.
- Dokumen panjang → ringkasan. PDF multi-halaman masuk context window Gemini, keluar ringkasan beserta kutipan halaman.
Cara mulai tanpa ribet
Buat saya, langkah paling murah mencoba multimodal adalah lewat API yang sudah tersedia: unggah gambar sebagai bagian dari chat completion biasa (tinggal kirim array konten bertipe image_url), atau pakai model open weight seperti Qwen2-VL lewat tool lokal kalau data tidak boleh keluar server. Yang perlu disiapkan cuma dua hal: prompt yang jelas soal format output yang diinginkan, dan contoh kasus nyata dari data sendiri. Saya biasanya mulai dari satu use case yang frustrasi (misalnya membaca faktur supplier yang formatnya berubah-ubah), bukan “coba semua modalitas sekaligus”.
Untuk audio, arsitektur yang umum masih berantai: Whisper (OpenAI, open weight) mengubah suara jadi teks, LLM memproses, lalu TTS menghasilkan suara balasan. Beda dengan GPT-4o yang audio masuk-keluar langsung. Rantai seperti ini lebih murah dan lebih mudah di-debug, mirip filosofi mikroservis yang biasa kita pakai — pecah masalah besar jadi langkah kecil yang bisa diganti satu per satu. Model end-to-end lebih mulus tapi mahal dan susah diobservasi. Episode #36 nanti kita bedah voice AI ini lebih dalam.
Batas yang masih menyebalkan
Pengalaman saya, kelemahan multimodal hari ini: (1) angka kecil di gambar — tabel rapat, resolusi rendah, digit sering salah baca; solusinya crop dulu atau kirim resolusi asli, jangan thumbnail. (2) Layout kompleks — kolom majalah, diagram berpotongan, urutan baca bisa tertukar. (3) Biaya dan latensi — token visual jauh lebih banyak dari teks; satu gambar 1000px bisa menghasilkan ratusan token. Untuk produksi, pertimbangkan degradasi: kalau model kecil cukup, jangan panggil model besar.
Pelajaran utama saya: multimodal bukan fitur ajaib, tapi perluasan input. Arsitektur sekitarnya — validasi output, guardrails, fallback — tetap sama seperti teks saja. Kalau di episode #34 kita sudah punya pola memaksa format benar, tinggal menambahkan tahap “baca gambar” di depannya.
Sumber
- OpenAI — Introducing GPT-4o: https://openai.com/index/hello-gpt-4o/
- Meta — Llama 3.2 announcement: https://ai.meta.com/blog/llama-3-2-connect-2024-vision-edge-devices/
- Google — Gemini model documentation (ai.google.dev/gemini-api/docs/models)
- Qwen VL GitHub: https://github.com/QwenLM/Qwen2-VL
- Belajar AI #33 (embedding): https://rudyhartadi.web.id/belajar-ai-33-embedding-vector-db-lebih-dalam-chunking-hybrid-search-dan-cosine-similarity/
Komentar Terbaru