Di episode #36 (Voice AI) kita sudah menyentuh keluhan paling khas dunia inferensi: latensi. Model besar bisa menghasilkan jawaban yang bagus, tapi menunggu token pertama keluar terasa lama. Nah, hari ini saya ingin mencatat apa yang saya pelajari tentang sisi yang jarang dibahas: kenapa inferensi LLM bisa lambat, dan trik-trik yang dipakai engine seperti vLLM untuk mempercepatnya. Bagi saya ini penting karena di episode #37 kita bahas AI coding assistant — di balik asisten-asisten itu ada server inferensi yang menerapkan teknik-teknik ini.
Dua fase: prefill dan decode
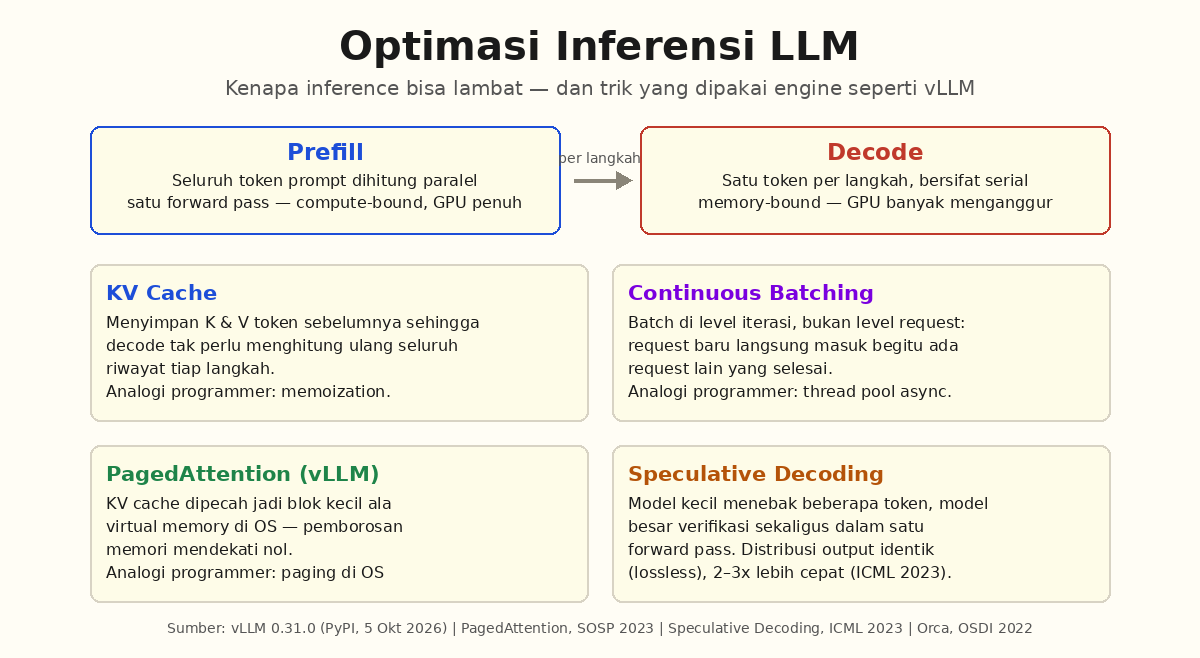
Saya baru menyadari bahwa inferensi LLM punya dua fase yang karakternya berbeda. Prefill: seluruh token prompt dihitung dalam satu forward pass — semua bisa paralel, GPU bekerja penuh. Decode: setelah prefill selesai, model menghasilkan jawaban satu token per langkah. Tiap token tergantung token sebelumnya, jadi sifatnya serial. Di sinilah letak ironinya: GPU modern punya kekuatan komputasi raksasa, tapi saat decode hanya dipakai sedikit — yang jadi botleneck adalah kecepatan membaca bobot model dari memori (memory bandwidth). GPU banyak menganggur, menunggu data.
KV cache: memoization untuk attention
Tanpa optimasi apa pun, tiap token baru harus menghitung ulang attention terhadap SELURUH riwayat percakapan. Ini pemborosan karena nilai attention token lama tidak berubah. KV cache menyimpan Key dan Value dari token-token sebelumnya, sehingga langkah decode berikutnya cukup menghitung token baru lalu melihat ke cache. Kalau kamu programmer, ini persis pola memoization: hasil komputasi mahal yang tidak berubah disimpan, bukan dihitung ulang.
Tapi KV cache punya masalah sendiri: ukurannya besar dan harus bertahan di GPU selama percakapan berlangsung. Untuk model 7B dengan riwayat ribuan token, cache ini bisa makan memori lebih besar dari bobot modelnya. Di sinilah teknik berikutnya masuk.
Continuous batching: antrian di level iterasi
Serving LLM berarti melayani banyak request bersamaan. Cara lama (static batching) mengumpulkan beberapa request, memprosesnya bersama, lalu melepas semuanya ketika request TERAKHIR selesai. Masalahnya: request yang jawabannya pendek harus menunggu yang panjang — GPU tetap bekerja tapi hasilnya mubazir menunggu. Continuous batching memindahkan penggabungan ke level iterasi: tiap langkah decode, sistem mengecek request mana yang sudah selesai, mengeluarkannya, dan memasukkan request baru. Ini mirip thread pool async — slot yang kosong langsung diisi, tidak ada worker nganggur menunggu yang paling lambat.
PagedAttention dan vLLM
KV cache dari banyak request punya masalah fragmentasi: tiap request dialokasikan memori sepanjang maksimum yang mungkin, padahal yang terpakai bisa jauh lebih sedikit. PagedAttention (paper SOSP 2023, yang melahirkan vLLM) memecah KV cache menjadi blok-blok kecil — persis cara operating system mengelola memori virtual dengan paging. Alokasi jadi dinamis: blok hanya diberikan saat dibutuhkan, dan blok yang sama bisa dipakai ulang. Pemborosan memori mendekati nol, sehingga batch yang muat jauh lebih besar dan throughput naik drastis.
vLLM sendiri sudah matang: versi 0.31.0 dirilis 5 Oktober 2026 di PyPI. Cukup satu perintah untuk menjalankan server OpenAI-compatible dari model open source:
python3 -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen2.5-7B-Instruct \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.9
Setelah jalan, aplikasi tinggal menunjuk base URL ke server ini tanpa mengubah kode — protokolnya sama dengan API OpenAI.
Speculative decoding: menebak dulu, verifikasi belakangan
Trik paling elegan menurut saya. Karena decode satu-satu itu memory-bound (membaca bobot model besar hanya untuk satu token), kenapa tidak menebak beberapa token sekaligus? Speculative decoding (Leviathan dkk., ICML 2023) memakai model kecil dan cepat untuk meneruskan draf beberapa token, lalu model besar memverifikasi semua draf itu dalam SATU forward pass. Token yang diterima dipakai; yang ditolak dikoreksi. Kuncinya: distribusi hasilnya dijamin identik dengan decoding biasa — percepatan tanpa mengorbankan kualitas. Paper aslinya menunjukkan percepatan 2x–3x pada T5-XXL. Syaratnya, model kecil harus sepakat dengan model besar cukup sering (acceptance rate tinggi), dan keduanya harus memakai tokenizer yang sama.
Yang saya catat
Intinya, bottleneck inferensi bukan pada “otak model” tapi pada memori dan orkestrasi. KV cache memotong komputasi berulang, continuous batching menjaga GPU tidak nganggur, PagedAttention mengatur memori secara efisien, dan speculative decoding memanfaatkan sisa kapasitas komputasi yang menganggur itu. Empat teknik ini bukan teori jauh — semuanya sudah otomatis di vLLM dan engine sejenis, jadi sebagai pemakai kita cukup paham konsepnya untuk memilih konfigurasi yang tepat. Untuk aplikasi dengan budget atau latensi ketat (misalnya voice agent di episode #36), pemahaman ini langsung terasa manfaatnya.
Sumber
- Kwon, W. dkk. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention — paper vLLM, SOSP 2023.
- Leviathan, Y., Kalman, M., Matias, Y. (2023). Fast Inference from Transformers via Speculative Decoding — ICML 2023.
- Daniel, C. dkk. vLLM blog: PagedAttention dan dokumentasi resmi docs.vllm.ai.
- PyPI: vllm 0.31.0 (rilis 5 Oktober 2026).
- Yu, G.-In dkk. (2022). Orca: A Distributed Serving System for Transformer-Based Generative Models — OSDI 2022, asal-usul continuous batching.
Komentar Terbaru