Di episode #57 kita sudah menjalankan model AI di VPS dan laptop — satu langkah lebih jauh ke bawah: ke dalam genggaman tangan. Di episode ini saya mencatat apa yang sebenarnya bisa berjalan di HP pada 2026, kerangka kerja apa yang dipakai untuk menjalankannya, dan jebakan nyata yang jarang dibahas orang. Ini penting bagi saya karena belum tentu setiap fitur AI di aplikasi saya layak membakar kuota dan biaya API setiap kali dipanggil.
Kenapa AI harus turun ke perangkat
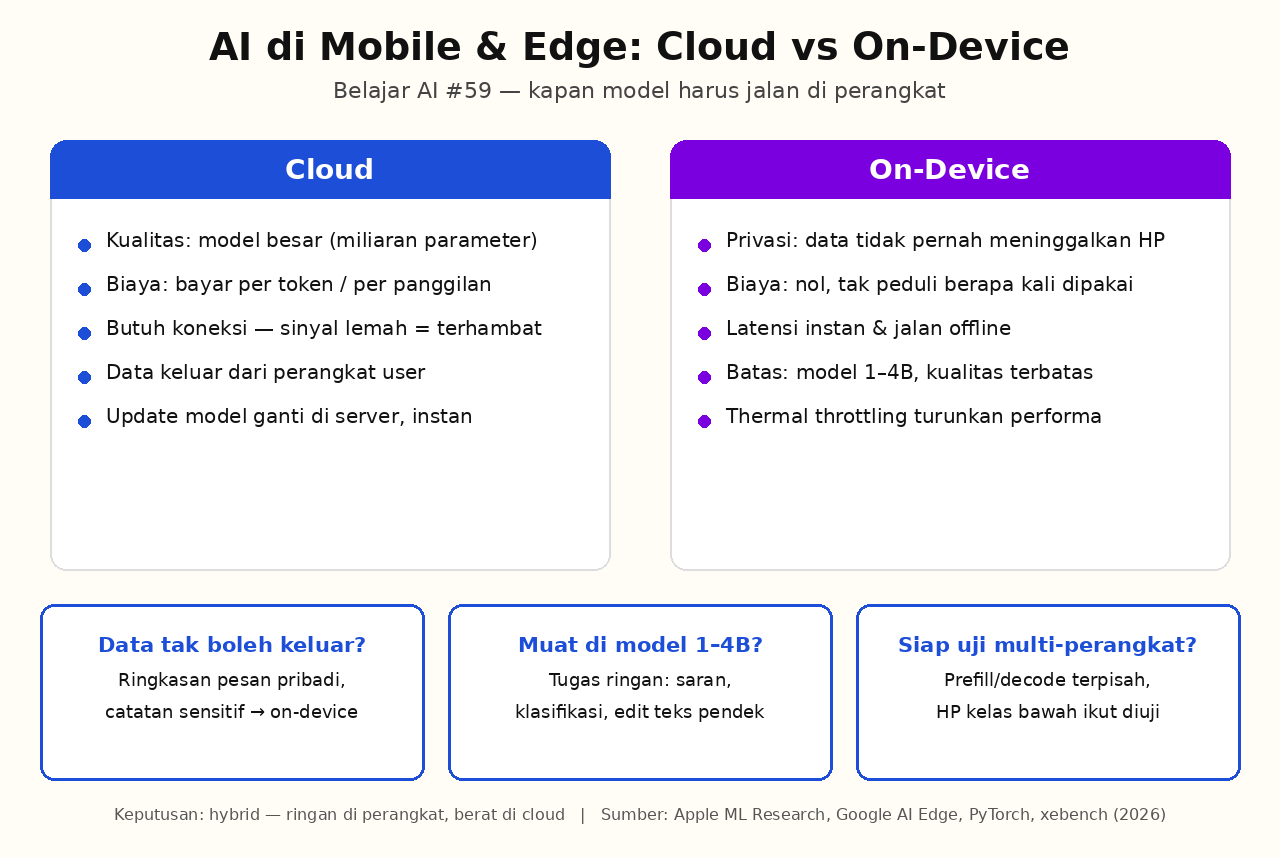
Tiga alasan yang paling sering saya temui: privasi, biaya, dan latensi. Kalau fitur AI saya memproses pesan/chat pribadi user di cloud, saya harus percaya diri soal keamanan data tersebut — kalau modelnya jalan di perangkat, data tidak pernah keluar. Biayanya nol: tidak ada token yang dibayar ke provider, berapa kali pun fitur itu dipakai. Latensinya juga beda kelas — tidak ada ronde jaringan, jadi respon terasa instan bahkan saat sinyal lemah atau sedang offline.
Ini berarti bagi saya sebagai programmer: keputusan “cloud atau on-device” bukan lagi soal tren, tapi soal jenis fitur. Ringkasan teks pendek, saran otomatis, klasifikasi kecil — kandidat bagus untuk on-device. Tanya-jawab pengetahuan umum atau tugas berat tetap milik cloud.
Apa yang benar-benar bisa jalan di HP (2026)
Kenyataannya lebih baik dari yang saya kira dua tahun lalu. Model sekitar 3 miliar parameter kini standar di perangkat kelas atas. Apple merilis model on-device ~3B untuk Apple Intelligence dengan kompresi ekstrem: bobot decoder 2-bit lewat quantization-aware training, ditambah berbagi KV-cache antar-token yang menurut Apple memangkas pemakaian memori 37,5%. Skornya di MMLU 67,85% — sedikit di atas Qwen-2.5-3B. Google’s Gemini Nano berjalan lewat AICore di Pixel dan Galaxy kelas atas, dan versi di Tensor G5 dilaporkan 2,6x lebih cepat dari Tensor G4. Qualcomm menonjolkan Hexagon NPU di Snapdragon 8 Elite Gen 5 yang sanggup menghasilkan hingga 220 token per detik.
Di sisi open model, varian kecil dari Gemma, Phi-4-mini, Llama 3.2 (1B/3B), hingga Qwen berukuran 0,8B–4B semuanya terbukti jalan berguna di HP. Bahkan MLPerf Mobile v6.0 dari MLCommons (2026) sudah memuat benchmark Llama 8B di NPU — ukuran yang setahun sebelumnya masih terasa seperti urusan data center. Ini berarti: model yang dulu cuma bermimpi di server, sekarang masuk daftar “layak dicoba” untuk aplikasi mobile.
Kerangka kerja yang tersedia
Ini bagian yang paling cepat berubah, jadi saya catat tanggalnya. Apple punya Foundation Models framework (iOS 26, rilis September 2025) — API Swift yang langsung membuka model ~3B itu dengan guided generation, tool calling, dan toolkit Python untuk melatih adapter rank 32 sendiri. Google punya LiteRT-LM, penerus resmi MediaPipe LLM Inference API yang kini berstatus maintenance-only; LiteRT-LM sendiri masih versi 0.18.0 (Oktober 2026, belum 1.0) dan mendukung model Gemma, Llama, Phi-4, Qwen plus function calling dengan constrained decoding. PyTorch punya ExecuTorch 1.0 yang menjanjikan konversi minim dari model PyTorch biasa ke perangkat edge. Dan llama.cpp tetap hidup di mobile lewat binding seperti llama.rn — jalur yang sama dengan yang kita bahas di episode #57, hanya kali ini di telapak tangan.
Jebakan nyata yang jarang dibahas
Hal pertama yang saya pelajari: tidak ada “engine tercepat” tunggal. Benchmark lintas-engine (xebench) menunjukkan peringkat berbalik-balah per model, per metrik, bahkan per HP — LiteRT-LM lebih cepat di prefill di satu ponsel, llama.cpp menang di decode di ponsel lain. NPU juga tidak otomatis menang dari CPU untuk segala hal.
Hal kedua: prefill dan decode punya karakter berbeda. Prefill jenuh di komputasi, cocok untuk NPU/GPU; decode tercekik bandwidth memori. Satu studi bahkan menemukan di ponsel kelas bawah, CPU bisa 2,65x lebih cepat dari GPU untuk decode — kebalikan dari flagship. Hal ketiga, dan ini yang paling sering bikin janji benchmark palsu: thermal throttling. Pengukuran berulang menunjukkan GPU flagship turun 31% setelah tiga kali run berturut-turut. Angka puncak di datasheet ≠ angka yang user rasakan setelah memakai aplikasi beberapa menit.
Pelajaran praktisnya: kalau saya serius ingin on-device, saya harus menguji di perangkat target nyata (termasuk yang kelas bawah), mengukur prefill dan decode terpisah, dan menyiapkan fallback ke cloud saat perangkat tidak mampu — persis pola fallback yang sudah kita bicarakan di episode #43.
Keputusan: kapan lokal masuk akal
Ringkasnya, saya pakai tiga pertanyaan: Apakah data ini tidak boleh keluar perangkat? Apakah fiturnya cukup ringan untuk model 1–4B? Apakah saya sanggup menguji di beberapa perangkat sekaligus? Kalau dua-tiga jawabannya ya, on-device layak dicoba. Kalau tidak, hybrid adalah jalan tengah yang paling waras: ringan di perangkat, berat di cloud. Dan satu catatan jujur: kalau nanti saya butuh kualitas lebih tinggi dengan anggaran terbatas, jalur self-host di VPS/laptop dari episode #57 masih relevan — on-device bukan satu-satunya alternatif dari API berbayar.
Sumber
- Apple Machine Learning Research — Updates to Apple’s On-Device and Server Foundation Language Models: https://machinelearning.apple.com/research/apple-foundation-models-2025-updates
- Apple Newsroom — Apple’s Foundation Models framework unlocks new intelligent app experiences (Sept 2025): https://www.apple.com/newsroom/2025/09/apples-foundation-models-framework-unlocks-new-intelligent-app-experiences
- Google AI Edge — LiteRT-LM Overview: https://developers.google.com/edge/litert-lm/overview
- Google AI Edge — MediaPipe LLM Inference (maintenance-only notice): https://developers.google.com/edge/mediapipe/solutions/genai/llm_inference
- PyTorch Blog — Introducing ExecuTorch 1.0: https://pytorch.org/blog/introducing-executorch-1-0/
- xebench — cross-engine on-device LLM benchmark: https://github.com/a-ghorbani/xebench
- lexa-edge-benchmarks — pengukuran Gemma 4 E2B di dua generasi perangkat (Sept 2026): https://github.com/blyzai/lexa-edge-benchmarks
- arXiv 2505.15030 — A Systematic Evaluation of On-Device LLMs
Komentar Terbaru