Di episode #38 kita sudah bedah kenapa inferensi LLM bisa mahal dan lambat, dan di episode #42 kita bahas sisi keamanannya. Kali ini saya catat sisi yang sering terlupakan sampai tagihan bulanan datang: menjalankan AI di produksi. Ini bukan soal model mana yang paling akurat di benchmark, tapi soal bagaimana supaya sistem tetap jalan, tidak meledak biayanya, dan bisa dilacak saat ada yang aneh.
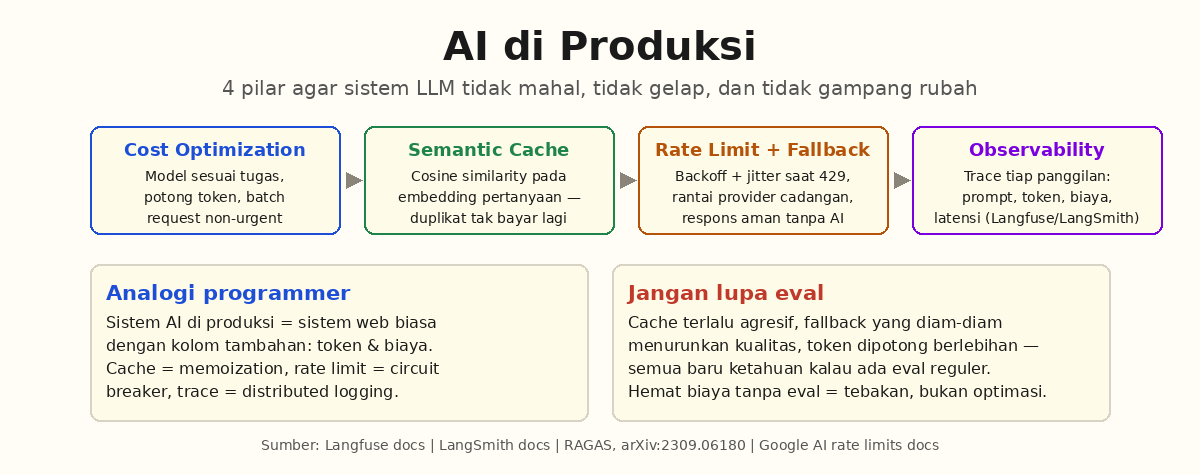
Cost optimization: pengeluaran yang bisa ditekan
Pengalaman saya, biaya LLM di produksi jarang mahal karena prompt-nya berat — lebih sering karena panggilan yang tidak perlu. Tiga hal yang paling cepat saya tekan:
- Pilih model sesuai tugas. Ringkasan email tidak butuh model flagship. Pola yang umum: model besar untuk kasus sulit, model kecil/lokal untuk tugas rutin.
- Potong token. System prompt yang tumpang tindih dari beberapa iterasi, riwayat chat yang tidak pernah dibuang, konteks yang di-fetch tapi tidak dipakai — semuanya dibayar per token.
- Batch request non-urgent. Kalau hasilnya boleh datang dalam hitungan menit, kumpulkan lalu kirim batch — banyak provider memberi harga diskon khusus batch API.
Semantic cache: jawab pertanyaan yang sama dua kali
Pola paling gampang menghemat: caching berbasis kemiripan semantik. Kalau ada pertanyaan yang secara makna sama dengan yang pernah dijawab sebelumnya, langsung kembalikan jawaban lama tanpa memanggil model lagi. “Bagaimana cara reset password?” dan “lupa password harus bagaimana?” seharusnya kena cache yang sama — beda dengan caching string persis yang tidak ada gunanya untuk bahasa natural.
Di kode kira-kira begini: simpan pertanyaan lama sebagai embedding, lalu setiap pertanyaan baru cek cosine similarity terhadap cache — di atas ambang (misal 0,95) dianggap duplikat. Ini memakai lagi materi embedding dari episode #33, dan ambangnya harus dikalibrasi: terlalu rendah, jawaban salah diberikan ke pertanyaan yang beda konteks; terlalu tinggi, cache tidak pernah kena.
Rate limit dan fallback: rencana saat provider sedang rusak
Provider besar pernah outages — itu fakta, bukan kemungkinan. Yang saya siapkan selalu dua hal: rate limit di sisi aplikasi (supaya satu user atau satu bug loop tidak menghabiskan kuota harian) dan rantai fallback (provider utama gagal → provider cadangan → kalau dua-duanya mati, respons yang berguna tanpa AI, bukan error 500 ke pengguna).
Retry perlu hati-hati: otomatis retry pada 429 tanpa backoff justru memperparah rate limit. Tambahkan exponential backoff + jitter supaya semua client tidak menyerang provider bersamaan saat batas reset.
Observability: Langfuse dan LangSmith
Ini bagian yang paling menyesakkan kalau dilewat: saat jawaban model aneh, saya tidak bisa menebak — saya butuh jejak. Tool observability LLM modern mencatat setiap panggilan: prompt masuk, respons keluar, token terpakai, latency, biaya kumulatif, sampai hasil evaluasi. Dua nama yang paling sering saya temui:
| Tool | Catatan |
|---|---|
| Langfuse | Open source, bisa self-host, tracing + eval + cost tracking |
| LangSmith | SaaS dari pembuat LangChain, terintegrasi erat dengan LangGraph |
Bagi saya yang paling penting bukan tool-nya, tapi kebiasaannya: setiap panggilan LLM harus punya trace ID, dan setiap keluhan user harus bisa ditelusuri ke trace-nya. Ini konsep yang sama dengan logging dan distributed tracing di sistem biasa — LLM hanya menambah kolom token dan biaya.
Praktik konkret yang saya terapkan: aktifkan tracing dari hari pertama proyek, bukan setelah ada insiden. Biaya tracing hampir nol dibanding satu minggu menebak-nebak kenapa tagihan melonjak atau kenapa jawaban model tiba-tiba berubah padahal kode tidak disentuh.
Catatan penutup
Meski demikian, semua pola di atas tidak menggantikan eval. Cache yang terlalu agresif, fallback yang diam-diam menurunkan kualitas, penghematan token yang memotong konteks penting — semuanya baru terlihat kalau ada eval reguler seperti yang kita bahas di episode #30. Di produksi, menghemat biaya tanpa eval itu bukan optimasi, itu tebakan.
Ini yang saya catat untuk diri saya sendiri: bikin sistem AI di produksi itu 30% soal model, 70% soal hal-hal membosankan di sekitarnya — cache, limit, fallback, dan trace. Hal membosankan itu yang bikin tidur nyenyak.
Komentar Terbaru