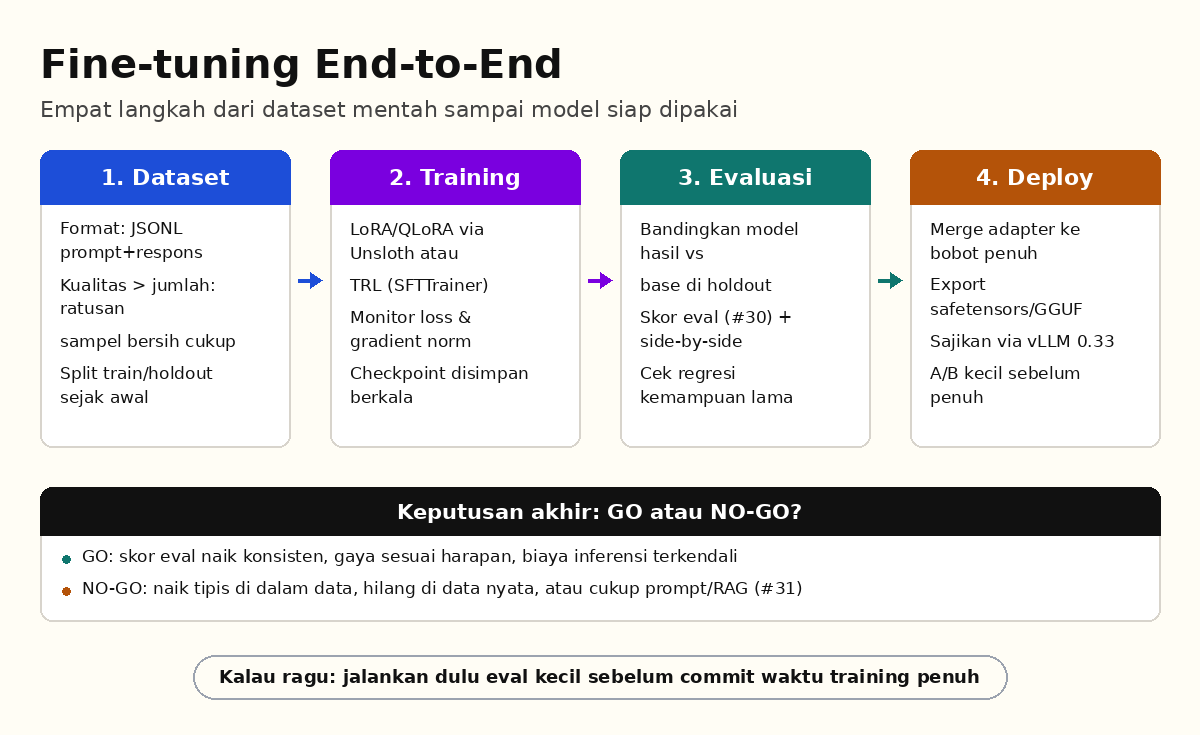
Di episode #52 saya belajar memilih model dengan tenang, dan kesimpulan terbesarnya: kalau evaluasi sendiri menunjukkan tidak ada model yang cocok, pilihan berikutnya adalah melatih model sendiri. Di catatan ini saya merangkai rantai kerja fine-tuning dari ujung ke ujung — menyiapkan data, melatih, mengevaluasi, sampai menyajikannya — dan yang paling penting, kriteria go/no-go sebelum saya membuang waktu training penuh. Di episode #31 saya sudah menentukan kapan fine-tuning layak dipilih; di sini saya bedah bagaimana jalannya.
Menyiapkan dataset: bagian yang paling menentukan
Saya dulu mengira training adalah bagian paling rumit. Ternyata tidak. Yang paling menentukan justru data: model hanya sebaik contoh yang saya berikan. Untuk tugas percakapan, format yang umum adalah JSONL — satu baris satu contoh berisi daftar pesan:
{"messages":[{"role":"user","content":"Tulis ringkasan berita teknologi"},{"role":"assistant","content":"Berikut ringkasannya dalam tiga poin..."}]}Prinsip yang saya catat untuk diri sendiri: kualitas jauh lebih penting dari jumlah. Dua ratus sampel yang bersih, konsisten, dan benar-benar mewakili kasus nyata lebih berguna daripada sepuluh ribu hasil salin-tempel dari sumber acak. Saya juga mempelajari satu pelajaran mahal: split data train dan holdout sejak menit pertama. Holdout itu seperti unit test yang tidak pernah dilihat model saat belajar — kalau saya mencampur semuanya, skor evaluasi nanti akan bohong, dan saya baru sadar setelah meluangkan waktu training percuma. Serangan klasik data: contoh duplikat, jawaban dengan format campur aduk, dan data yang ternyata bocor dari benchmark. Semua itu membersihkannya di tahap ini jauh lebih murah daripada di tahap akhir.
Training: pilih alat yang sudah terbukti, jangan menulis dari nol
Untuk penyetelan halus dengan parameter efisien (LoRA/QLoRA), saya tidak perlu menghitung gradien sendiri — pustaka yang sudah matang mengerjakan bagian itu. Pilihan praktis saya saat ini, dengan versi yang saya cek langsung dari PyPI pada 6 November 2026:
- Unsloth (versi 2026.11.2, rilis 4 November 2026) — training LoRA/QLoRA yang cepat dan hemat VRAM; ini yang paling sering saya pakai untuk eksperimen kecil.
- TRL dari Hugging Face (versi 1.17.1, rilis 30 Oktober 2026) — berisi SFTTrainer yang jadi tulang punggung pelatihan terawasi; pustaka ini sudah stabil di jalur 1.x sejak Maret 2026.
- PEFT (versi 0.21.2, rilis 1 Oktober 2026) — lapisan adapter LoRA yang dipakai hampir semua pustaka di atas.
- Axolotl (0.21.1, 27 Oktober 2026) dan LlamaFactory (0.9.5, 30 Mei 2026) — alternatif berbasis file konfigurasi, cocok kalau saya ingin menjalankan banyak eksperimen tanpa menyentuh kode Python.
Kerangka pelatihannya sendiri pendek. Kuncinya bukan panjang kode, melainkan dua hal: eval_dataset yang saya sisihkan sejak awal, dan pengaturan evaluasi per epoch supaya saya melihat kurva, bukan cuma angka akhir:
from trl import SFTConfig, SFTTrainer

args = SFTConfig(
    output_dir="out",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=3,
    eval_strategy="epoch",
    gradient_checkpointing=True,
)
trainer = SFTTrainer(
    model=model, args=args,
    train_dataset=ds_train, eval_dataset=ds_holdout,
)
trainer.train()
print(trainer.evaluate())
Evaluasi: bandingkan dengan model dasar, bukan dengan harapan saya
Setelah training selesai, godaan terbesar adalah langsung menyimpulkan “berhasil” karena kelihatannya bagus di chat. Cara saya menahan godaan itu: jalankan dua model di holdout yang sama — model dasar dan model hasil latihan — lalu bandingkan skornya berdampingan. Cara praktisnya persis yang saya tulis di episode #30: set kasus uji kecil, skor otomatis kalau jawabannya terstruktur, penilaian model lain kalau gaya bicara. Tiga kegagalan yang paling sering saya temukan: skor naik di data latihan tapi datar di data nyata (artinya model hafal, bukan belajar), kemampuan lama justru menurun (regresi — misalnya model jadi lupa format yang dulu benar), dan kualitas jawaban membaik rata-rata tapi anjlok di kasus pinggiran. Karena itu saya selalu menyimpan beberapa kasus sulit di holdout, bukan cuma yang mudah.
Deploy: dari adapter ke endpoint
Hasil LoRA bukan file model utuh — hanya sisipan bobot kecil. Sebelum dipakai produksi, adapter digabungkan ke model dasar lalu diekspor sebagai safetensors (atau GGUF kalau nanti dijalankan lokal). Penyajiannya saya serahkan ke mesin inferensi seperti vLLM (versi 0.33.0 saat saya cek pada 2 November 2026), yang sudah dibahas dari sisi optimasinya di episode #38. Satu kebiasaan yang saya ambil: rilis kecil dulu — A/B atau canary ke sebagian kecil pengguna — sebelum mengganti seluruh trafik. Model baru yang lolos eval pun bisa berperilaku aneh di kondisi trafik asli, dan mengganti endpoint sepenuhnya dalam satu langkah itu seperti deploy tanpa rollback. Untuk pantauan biaya dan kualitas pasca-rilis, saya merujuk pola di episode #43.
Keputusan go/no-go
Ini bagian yang paling saya jaga: sebelum menghabiskan waktu training penuh, saya tulis dulu syarat keberhasilannya secara eksplisit. GO kalau skor eval naik konsisten di beberapa epoch, gaya jawabannya sesuai harapan, dan biaya inferensi model hasil latihan masih terkendali. NO-GO kalau kenaikannya hanya terasa di dalam data latihan, kalau kemampuan dasar malah menurun, atau — yang paling sering — kalau ternyata masalahnya selesai hanya dengan prompt yang lebih baik atau RAG, seperti keputusan di episode #31. Keputusan no-go bukan kegagalan; itu penghematan waktu terbaik yang pernah saya dapat.
Yang saya bawa pulang dari catatan ini: fine-tuning bukan sihir — ia rantai kerja yang bisa dipecah jadi empat langkah yang masing-masing punya definisi “selesai” yang jelas. Data yang bersih, training yang terpantau, evaluasi yang jujur, dan rilis yang bertahap. Dengan urutan itu, keputusan di akhir jadi jauh lebih mudah dipertanggungjawabkan.
Sumber
- Unsloth — LoRA fine-tuning hyperparameters guide (dokumentasi resmi, diakses 6 November 2026)
- TRL di PyPI — riwayat rilis SFTTrainer (rilis terbaru 1.17.1, 30 Oktober 2026)
- Hugging Face PEFT — dokumentasi resmi
- vLLM di PyPI — mesin inferensi (rilis 0.33.0, 2 November 2026)
- Axolotl (GitHub) dan LlamaFactory (GitHub) — pelatihan berbasis konfigurasi
Komentar Terbaru