Di episode #39 kita memetakan model open source, dan di #48 kita bicara soal context window — tapi satu pertanyaan yang sering muncul di komentar dan chat saya belum pernah dijawab tuntas: bagaimana kalau saya mau menjalankan model itu sendiri, di mesin saya? Di catatan ini saya rangkum tiga jalur yang paling sering dipakai: Ollama, llama.cpp, dan vLLM. Ketiganya sama-sama “AI lokal”, tapi masuk akalnya di situasi yang sangat berbeda, dan saya baru paham perbedaannya setelah mencoba ketiganya.
Kenapa repot-repot jalankan lokal?
Alasan pertama yang saya alami: privasi. Begitu ada satu dokumen yang tidak boleh keluar kirim — kontrak klien, data pasien, kode internal — panggilan ke API cloud berhenti jadi pilihan. Alasan kedua: biaya yang bisa diprediksi. API cloud itu murah di awal, lalu tagihannya tumbuh tanpa terasa saat aplikasi mulai ramai (kita sudah hitung-hitungan di #43). Alasan ketiga: latensi dan ketersediaan. Model yang jalan di mesin sendiri tidak kenal rate limit, tidak kenal gangguan internet, dan tidak menambah satu hop jaringan lagi.
Tapi saya juga belajar jujur soal batasnya: model 70 miliar parameter tidak akan nyaman di laptop 16 GB, dan kualitas model open source terbaik masih berbeda dari model terbaru provider besar. Lokal bukan jawaban untuk semua kasus — lokal adalah keputusan tradeoff.
Tiga jalur, tiga karakter
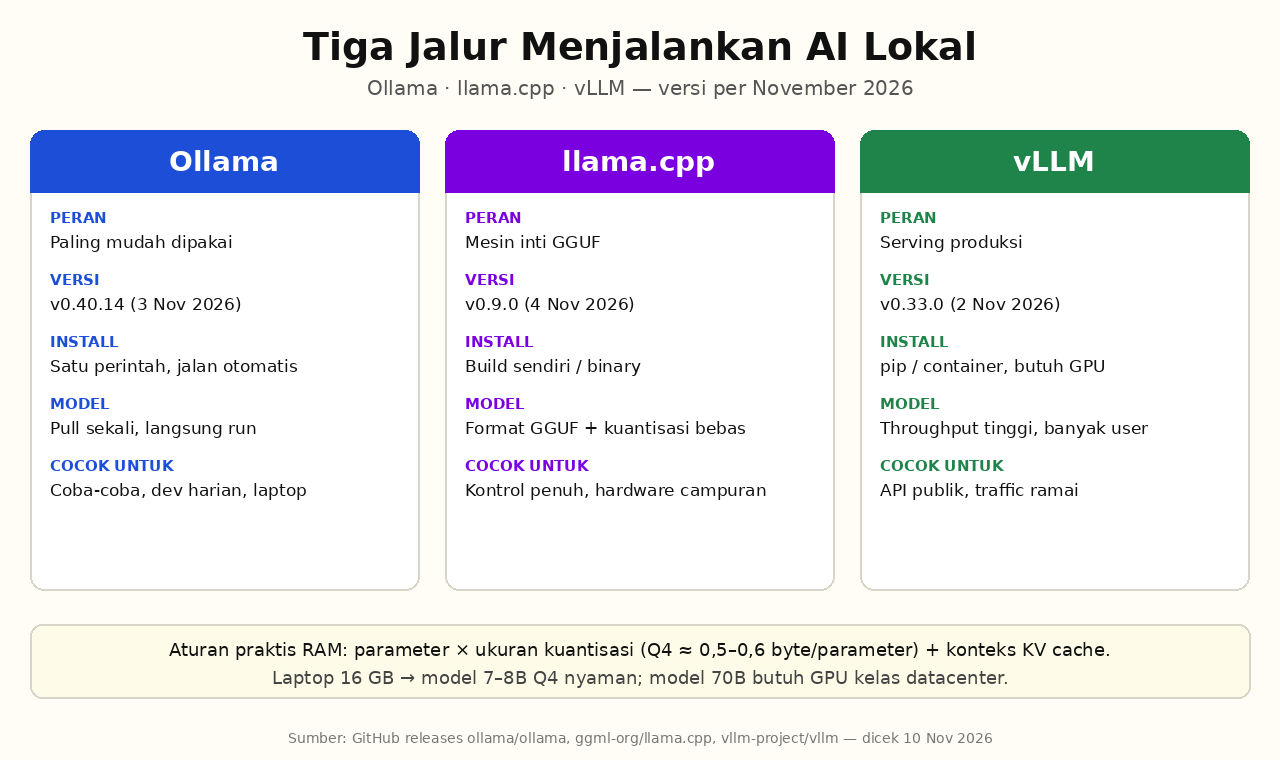
Ollama adalah pintu termudah. Filosofinya mirip npm install: satu perintah, model terunduh, server lokal jalan di port 11434, selesai. Versi stabil terbaru saat saya menulis ini adalah v0.40.14 (rilis 3 November 2026). Untuk eksperimen harian, prototipe, dan integrasi cepat ke aplikasi lewat endpoint OpenAI-compatible, Ollama hampir selalu pilihan pertama saya.
llama.cpp adalah mesin di balik banyak hal — termasuk mesin yang dipakai Ollama. Proyeknya kini berada di bawah ggml-org, dan versi rilisnya sudah menyentuh v0.9.0 (4 November 2026) dengan rilis build harian. Kalau Ollama memberi kenyamanan, llama.cpp memberi kontrol: pilihan kuantisasi GGUF yang detail, pengaturan konteks dan batch yang telanjang, serta kemampuan membangun binary untuk hardware yang tidak biasa (CPU lama, Raspberry Pi, bahkan backend Vulkan/Metal). Di #24 kita sudah sentuh kuantisasi GGUF — di sinilah “bengkel”nya berada.
vLLM bermain di kelas yang lain. Kalau dua yang di atas fokus ke “satu mesin, beberapa pengguna”, vLLM dirancang untuk serving produksi: banyak request bersamaan, throughput tinggi, dan manajemen memori GPU yang cerdas lewat PagedAttention (topik yang sudah kita bedah di #38). Rilis terbarunya v0.33.0 (2 November 2026). Syaratnya jelas: butuh GPU yang memadai dan sedikit kesabaran mengatur — bukan untuk dicoba-coba di laptop kantor.
| Tool | Peran | Cocok untuk | Syarat |
|---|---|---|---|
| Ollama | Paling mudah | Prototipe, dev harian | Laptop biasa |
| llama.cpp | Kontrol penuh | Optimasi per-hardware | Rakit sendiri |
| vLLM | Serving produksi | Traffic ramai, banyak user | GPU kelas server |
Aturan praktis RAM yang saya pakai
Sebelum menarik model, saya hitung dulu: parameter × ukuran kuantisasi. Kuantisasi Q4 kira-kira 0,5–0,6 byte per parameter, ditambah ruang untuk KV cache konteks. Jadi model 8 miliar parameter berformat Q4 butuh sekitar 5–6 GB, model 70 miliar butuh 40 GB lebih — dan itu belum termasuk konteks panjang. Rumus sederhana ini yang menyelamatkan saya dari berkali-kali mengunduh model yang akhirnya tidak muat.
# Ollama: sekali jalan
ollama run qwen3:8b

# llama.cpp: kontrol penuh
llama-server -m model.gguf -c 8192 --n-gpu-layers 99

# vLLM: serving produksi (butuh GPU)
vllm serve Qwen/Qwen3-8B --max-model-len 32768
Kapan lokal benar-benar masuk akal?
Simpulan praktis saya. Lokal menang kalau: data wajib tidak keluar mesin, traffic cukup stabil sehingga biaya API per-bulan lebih mahal daripada satu GPU bekas, atau produknya memang butuh kerja offline (aplikasi lapangan, perangkat medis, dsb). Cloud menang kalau: tim kecil tidak mau mengelola infrastruktur, kebutuhan model melompat-lompat, atau kualitas model terdepan adalah nilai jual utama.
Banyak tim yang saya lihat akhirnya memakai keduanya: lokal untuk model kecil yang jalan terus (ringkasan, klasifikasi, embedding — lihat #33 untuk embedding), cloud untuk model besar yang dipanggil sesekali. Kombinasi seperti ini yang paling sering saya temukan masuk akal di lapangan, dan ini juga yang mendasari topik routing model di #62 nanti.
Sumber
- Ollama GitHub — https://github.com/ollama/ollama/releases
- llama.cpp GitHub (ggml-org) — https://github.com/ggml-org/llama.cpp/releases
- vLLM GitHub — https://github.com/vllm-project/vllm/releases
- vLLM documentation (PagedAttention & serving) — https://docs.vllm.ai/
- GGUF format (llama.cpp wiki) — https://github.com/ggml-org/llama.cpp/wiki/GGUF
Komentar Terbaru