Di episode sebelumnya kita membahas agent dari sisi pola kerjanya: ReAct, planning, desain tool. Kali ini saya mau turun satu level lagi ke hal yang sering diremehkan tapi menentukan kualitas semua itu — isi context window. Saya dulu mengira context engineering cuma “menulis prompt yang rapi”. Ternyata tidak: context adalah memori kerja agent, dan memori yang berantakan membuat agent pintar jadi bodoh. Di catatan ini saya kumpulkan cara menyusun konteks yang saya pakai sendiri, plus trik prompt caching yang menurut saya paling cepat terasa manfaatnya karena menekan biaya sekaligus latensi.
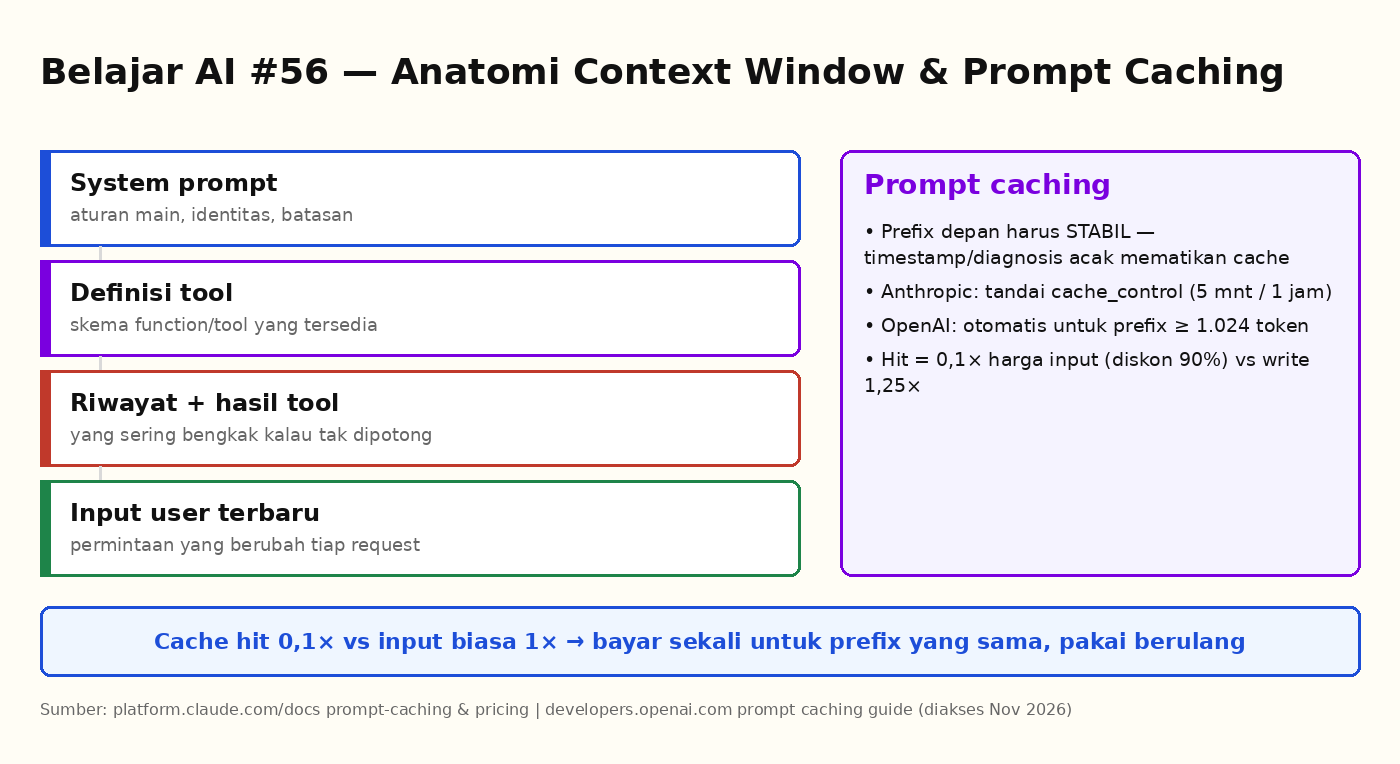
Konteks itu seperti RAM. Model tidak punya ingatan antar-percakapan — semua yang “dia tahu” tentang sesi berjalan ada di context window, dan setiap request ulang seluruh isi itu dikirim lagi dari awal. Karena itu menaruh hal yang salah di sana (instruksi basi, hasil tool yang tidak pernah dibuang, riwayat berbulan-bulan) sama saja dengan memori kerja penuh sampah. Konsep ini sebenarnya sudah kita sentuh di episode #40 soal memori agent; sekarang kita bedah sisi praktisnya.
Anatomi satu request: apa yang masuk ke context
Saat agent berjalan, satu request biasanya berisi urutan kira-kira begini: system prompt (aturan main, identitas, batasan), definisi tool, hasil-hasil tool dari langkah sebelumnya, ringkasan riwayat percakapan, lalu input user terbaru. Urutan ini penting, bukan cuma estetika. Semua model attention membaca seluruh sekuens setiap kali — posisi sebuah instruksi menentukan seberapa kuat instruksi itu diingat. Prinsip yang saya pegang: hal yang tidak boleh dilupakan model harus di depan dan stabil; hal yang berubah-ubah harus di belakang.
Praktiknya: jangan sisipkan timestamp baru (“waktu sekarang 09:14:33”) di bagian awal system prompt. Satu karakter berubah, seluruh prefix dianggap baru oleh cache — kita bahas di bawah. Kalau butuh waktu, taruh di akhir, atau perbarui per menit, bukan per detik.
Prompt caching: bayar sekali untuk prefix yang sama
Di episode #43 kita bahas caching hasil jawaban. Prompt caching beda level: yang di-cache adalah hasil hitungan prefix (state KV-cache, topik yang sama dengan optimasi inferensi di episode #38) — kalau request berikutnya memulai dengan prefix yang persis sama, model tidak perlu menghitung ulang bagian itu.
| Provider | Cara kerja | Angka kunci (cek terbaru) |
|---|---|---|
| Anthropic | Eksplisit: tandai cache_control pada breakpoint; TTL 5 menit (default) atau 1 jam | Write 5 menit = 1,25× harga input; write 1 jam = 2×; cache hit = 0,1× (diskon 90%) |
| OpenAI | Otomatis untuk prefix ≥1.024 token, hit cocok per kelipatan 128 token | Diskon cached input 50% (gpt-4o) sampai 90% (gpt-5.2); TTFT bisa ~80% lebih cepat |
Matematikanya sederhana: write 5 menit 1,25× lalu hit 0,1× → satu prefix yang dipakai dua kali sudah lebih murah daripada tanpa cache (1,35× vs 2×). Artinya bagi saya: selama prefix stabil dan request berulang dalam hitungan menit, caching praktis selalu menang. Tapi ada syarat diam-diam yang saya pelajari dengan susah payah: tiap model punya panjang minimum untuk bisa di-cache (misalnya 1.024 token untuk Sonnet 4.5/4.6, 4.096 untuk Haiku 4.5). Di bawah ambang itu, request tetap jalan tanpa error — hanya tidak pernah di-cache. Kalau mengecek usage dan cache_read_input_tokens selalu 0, itulah biasanya penyebabnya.
Agar konteks tidak bengkak
Agent yang berjalan lama punya kecenderungan rakus: setiap tool call menaruh hasil mentah ke memori, file besar dimasukkan utuh, riwayat tidak pernah diringkas. Gejalanya jelas — biaya naik non-linear, kualitas malah turun karena instruksi penting tenggelam di tengah. Beberapa aturan yang saya terapkan:
- Potong hasil tool. Keluaran script atau file 5.000 baris cukup 100 baris pertama + catatan “ada 4.900 baris lagi”; minta model meminta bagian lain bila perlu.
- Ringkas riwayat saat melewati ambang. Tukar 20 giliran lama dengan satu paragraf ringkasan keputusan penting, bukan hapus mentah-mentah.
- Jangan taruh dokumen basi di depan. Konteks yang hanya dibutuhkan sesekali (dokumen referensi, hasil pencarian) diletakkan setelah instruksi — supaya instruksi tetap prefix yang stabil.
- Ukur dulu, baru kompres. Catat token per request seperti layaknya log aplikasi; kompresi tanpa angka hanya menebak.
Ini berhubungan langsung dengan eval di episode #30: perubahan struktur konteks = perubahan perilaku, jadi selalu saya ukur ulang dengan eval yang sama sebelum dan sesudah. Yang mengejutkan, versi konteks yang lebih ringkas sering lebih akurat — bukan cuma lebih murah.
Checklist yang saya pakai
Saat review sebuah agent sebelum rilis, saya tanyakan lima hal: (1) apa saja yang masuk context tiap request dan apakah semuanya masih perlu; (2) apakah prefix depan benar-benar stabil, bebas timestamp/diagnosis acak; (3) apakah breakpoint cache sudah menembus panjang minimum model yang dipakai; (4) apakah hasil tool dipotong sebelum masuk memori; (5) apakah ada metrik cache hit rate yang dipantau. Lima pertanyaan ini terasa sepele, tapi dua di antaranya pernah menyelamatkan saya dari tagihan bulanan yang membengkak dua kali lipat hanya gara-gara satu baris tanggal di system prompt.
Inti catatan saya: context engineering bukan seni menulis prompt indah, tapi disiplin mengelola memori kerja — apa yang layak diingat, apa yang harus dibuang, dan bagian mana yang cukup dibayar sekali. Episode berikutnya kita pakai fondasi ini saat menjalankan model secara lokal di VPS atau laptop.
Sumber
- Anthropic — Prompt caching (dokumentasi resmi, diakses Nov 2026)
- Anthropic — Pricing (tabel multiplier cache 1,25× / 2× / 0,1×)
- OpenAI — Prompt caching guide
- OpenAI Cookbook — Prompt Caching 201 (angka diskon per model & dampak latensi)
- Anthropic Engineering — Effective context engineering for AI agents
Komentar Terbaru