Di episode #26 kita sudah membahas apa itu AI agent — program yang berjalan dalam loop perceive-reason-act dengan tool use. Di episode #40 saya catat cara supaya agent tidak gampang lupa lewat memori jangka pendek dan panjang. Kali ini saya ingin menyentuh satu keputusan desain yang sering membuat programmer salah ambil langkah: kapan satu agent sudah cukup, dan kapan kita perlu banyak agent sekaligus — yang namanya multi-agent. Jujur, saya sempat tergoda menganggap “makin banyak agent, makin pintar hasilnya”. Ternyata tidak sesederhana itu.
Multi-agent itu seperti apa
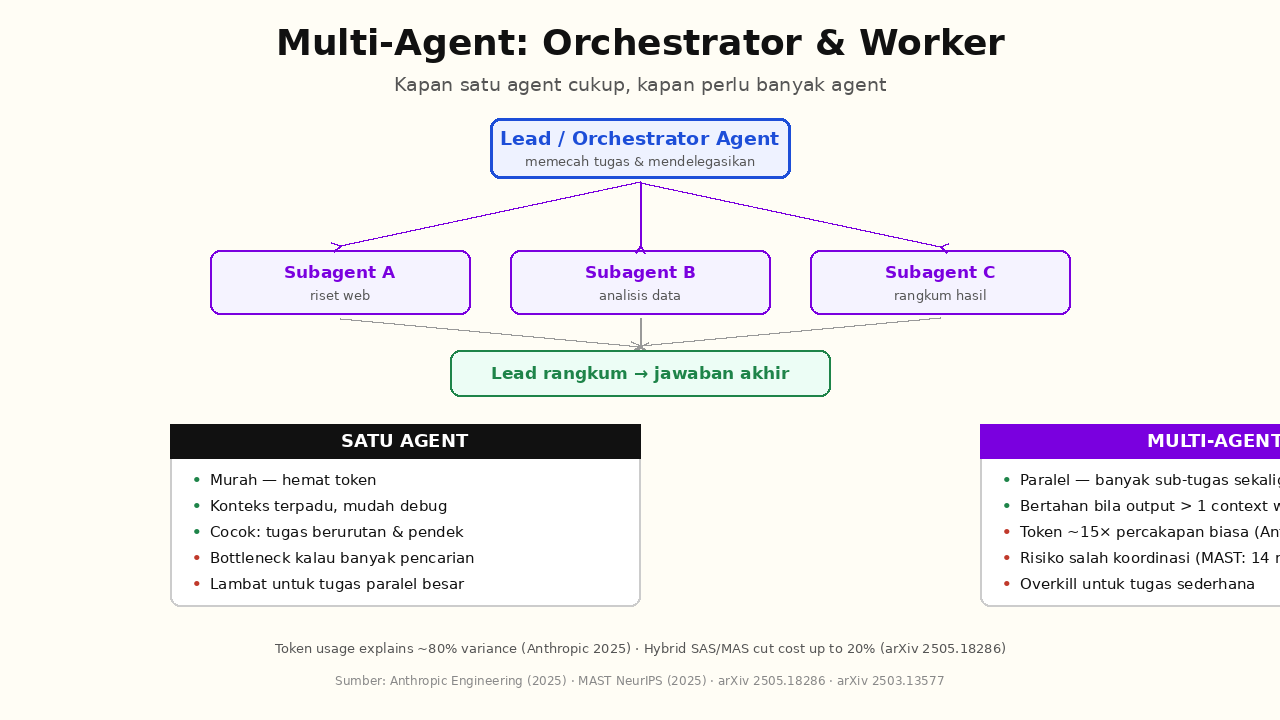
Saya suka membandingkannya dengan tim programmer. Satu agent itu seperti satu developer senior yang mengerjakan semuanya sendiri: riset, coding, lalu review. Multi-agent itu seperti ada satu tech lead yang memecah tugas besar menjadi beberapa sub-tugas, lalu mendelegasikannya ke beberapa worker yang bekerja paralel, dan di akhir lead menggabungkan hasilnya. Pola yang paling umum disebut orchestrator-worker: satu lead agent bertugas merencanakan dan membagi kerja, sedangkan subagent fokus mengerjakan satu potong tugas dengan context window-nya sendiri-sendiri.
Pola orchestration yang umum dipakai
- Orchestrator-worker — lead memecah tugas, subagent jalan paralel. Ini pola yang dipakai fitur riset Anthropic.
- Sequential / chain — hasil agent A menjadi input agent B. Cocok untuk pipeline yang memang berurutan, misalnya ekstrak → bersihkan → ringkas.
- Handoff / routing — agent saling melempar tugas sesuai keahlian, misalnya agent umum meneruskan ke agent khusus kode atau agent khusus SQL.
- Voting / consensus — beberapa agent menjawab pertanyaan yang sama, lalu jawaban dipilih berdasarkan mayoritas atau penguat suara.
Bukti nyata dari riset Anthropic
Yang membuat saya berhenti sejenak adalah angka dari tim Anthropic saat membangun sistem riset multi-agent mereka (2025). Dengan lead agent Claude Opus 4 dan subagent Claude Sonnet 4 yang bekerja paralel, sistem itu unggul 90,2% dibanding satu Claude Opus 4 tunggal pada eval riset internal mereka. Tapi ada catatan penting: multi-agent membakar token jauh lebih banyak — rata-rata sekitar 15 kali percakapan biasa, sementara satu agent tunggal sekitar 4 kali. Bahkan token usage sendiri menjelaskan sekitar 80% variasi performa pada benchmark BrowseComp. Ini berarti bagi saya: multi-agent bukan soal modelnya jadi lebih pintar, melainkan soal kapasitas token paralel yang lebih besar — kita membayar lebih banyak komputasi untuk menyelesaikan masalah yang tidak muat di satu context window.
Kapan multi-agent jadi overkill
Ada studi 2025 (arXiv 2505.18286) yang membandingkan multi-agent dengan single-agent di banyak tugas agentic. Temuannya menarik: keunggulan multi-agent menyusut ketika model dasarnya makin kuat, dan pada tugas sederhana multi-agent justru bisa kalah karena overthinking — para agent terlalu banyak berpikir berlebihan. Studi lain (arXiv 2503.13577) menegaskan bahwa orchestration hanya berguna kalau memang ada perbedaan performa atau biaya antar agent; kalau semua agent modelnya sama dan tugasnya tidak butuh pembagian kerja, koordinasi itu mubazir. Anthropic sendiri menyebut bahwa sebagian besar tugas coding justru kurang paralel — banyak bagiannya saling bergantung — sehingga kurang cocok untuk multi-agent dibanding tugas riset yang benar-benar menyebar.
Kenapa multi-agent sering gagal
Studi MAST (NeurIPS 2025) menganalisis lebih dari 1.600 trace dari 7 framework multi-agent dan menemukan 14 mode kegagalan yang terbagi dalam tiga kategori: masalah rancangan sistem (system design), salah selaras antar agent (inter-agent misalignment), dan verifikasi tugas yang lemah (task verification). Ini meyakinkan saya bahwa kegagalan multi-agent jarang terjadi karena modelnya bodoh — lebih sering karena komunikasi antar agent tidak jelas dan hasilnya tidak diverifikasi. Ketika lead memecah tugas terlalu samar, subagent bisa mengulang pekerjaan yang sama, menutupi celah, atau saling meniru.
Keputusan desain ala programmer
Supaya tidak tergoda over-engineering, saya bikin kecil keputusan ini seperti memilih antara satu proses atau banyak proses paralel. Analoginya kira-kira begini:
# Analogi sederhana orchestrator-worker
def lead_agent(tugas):
    subtasks = pecah(tugas)              # delegate
    hasil    = jalankan_paralel(subtasks)  # banyak context window
    return rangkum(hasil)                 # gabungkan

# Pakai multi-agent HANYA kalau:
# 1) subtasks benar-benar independen satu sama lain
# 2) nilainya cukup tinggi untuk bayar token ~15x
# 3) hasil tiap subagent bisa diverifikasi
Kalau salah satu syarat di atas tidak terpenuhi, saya cenderung bertahan dengan satu agent dulu. Lebih mudah debug satu context window daripada menelusuri kesalahan di lima context window yang saling berbicara.
Tabel keputusan: kapan pakai mana
| Kriteria | Satu agent | Multi-agent |
|---|---|---|
| Tugas berurutan & pendek | Cocok | Overkill |
| Banyak sub-tugas independen | Lambat | Cocok |
| Semua butuh konteks yang sama | Cocok | Sulit |
| Anggaran token ketat | Cocok | Mahal (±15×) |
| Nilai hasil tinggi & menyebar luas | Cukup | Layak |
Inti yang saya ambil: multi-agent bukan tren yang wajib diikuti, melainkan alat dengan biaya nyata. Ia paling berharga untuk tugas yang menyebar luas (banyak arah pencarian independen), informasi yang melebihi satu context window, dan pekerjaan dengan banyak tool kompleks. Untuk sisanya, satu agent yang dirancang baik — dengan memori yang cukup seperti di episode #40 dan tool use yang rapi seperti di episode #26 — biasanya sudah lebih dari cukup.
Komentar Terbaru