Di episode #26 kita sudah membahas konsep AI Agent: program yang punya loop perceive-reason-act dan memanggil tools. Nah, kalau ada satu keluarga produk yang paling langsung terasa manfaatnya bagi programmer seperti kita, itu adalah AI coding assistant. Di episode ini saya catat bagaimana cara kerjanya, dan yang paling penting: bedanya mode “autocomplete” dengan mode “agentic edit” yang muncul belakangan.
Dua mode yang sering disamakan
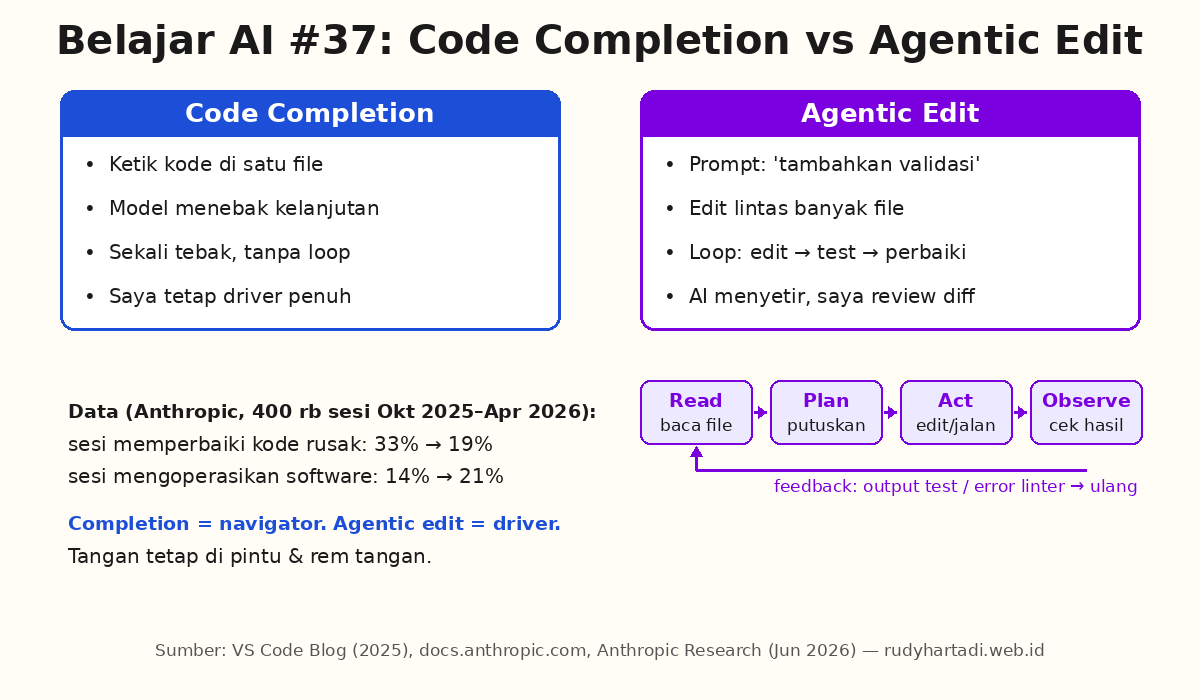
Seringkali orang bilang “AI nulis kode” tanpa membedakan dua hal yang cara kerjanya sangat berbeda. Saya sendiri awalnya juga menganggapnya sama, sampai mencoba keduanya berdampingan. Ini tabel yang saya buat untuk merapikan pemahaman saya:
| Aspek | Code completion | Agentic edit |
|---|---|---|
| Input | Kursor di file, beberapa baris kode | Prompt natural language (“tambahkan validasi email”) |
| Cakupan | Satu posisi kursor, satu file | Banyak file sekaligus |
| Loop | Sekali tebak, sekali sugesti | Edit → run test/lint → perbaiki → ulang |
| Kontrol programmer | Tinggi (terima/tolak per baris) | Lebih rendah (review diff menyeluruh) |
| Cocok untuk | P boilerplate, autocomplete sintaks | Refactor lintas file, fitur kecil end-to-end |
Cara kerja code completion
Mode completion paling tua dan paling sederhana. Model menerima konteks di sekitar kursor — file aktif, beberapa file terkait, mungkin struktur project — lalu menebak kelanjutan teksnya. Ini dijalankan sekali, tanpa loop. Kalau tebakannya jelek, ya programmer mengabaikan sugestinya dan mengetik sendiri. Bagi saya ini terasa seperti ” autocomplete yang sangat pintar”: nyaman untuk menulis kode rutin, tapi tidak pernah menyentuh file lain dan tidak pernah mengecek apakah hasilnya benar.
Cara kerja agentic edit
Mode agentic edit memakai loop yang sama persis dengan konsep agent di episode #26, hanya saja tools-nya khusus coding: membaca file, menulis file, menjalankan perintah terminal. Kalau di episode #27 kita bahas function calling sebagai jembatan model ke kode kita, di sinilah jembatan itu dipakai secara nyata tiap beberapa detik. Loop-nya kira-kira seperti ini:
while not task_done:
    files  = read_relevant_files(task)     # tool: baca file project
    plan   = model.generate(task, files)   # model tentukan langkah
    action = plan.next_action()            # edit file / run command
    result = execute(action)               # jalankan di terminal
    feedback = observe(result)             # output test, error linter
    task_done = plan.is_done(feedback)     # selesai atau coba lagi
Yang membuat mode ini terasa ajaib justru bagian observe-nya: agent membaca output test yang gagal atau error linter, lalu memperbaiki kode sendiri sebelum hasilnya sampai ke saya. Ini persis loop “act-observe” yang kita bahas di episode #26, hanya konkretnya di dunia kode.
Peta tools: Copilot, Cursor, Claude Code, dan agent CLI
| Tool | Bentuk | Catatan saya |
|---|---|---|
| GitHub Copilot | Ekstensi IDE (VS Code, Visual Studio) | Completion + agent mode di chat; agent mode bisa bereaksi ke error compile/lint dan mengulang sampai beres |
| Cursor | IDE berbasis VS Code | Agent edit jadi fitur utama; diff review antar file nyaman |
| Claude Code | CLI di terminal, ekstensi IDE, app desktop | Agent yang baca seluruh codebase, jalankan perintah, dan punya file memori proyek (CLAUDE.md) |
| Agent CLI lain | CLI open-source (mis. Aider, OpenCode) | Pola sama: terminal sebagai “kendali”, model sebagai otak |
Perhatikan polanya: industri sedang bergerak dari IDE sebagai tempat completion, menuju terminal sebagai tempat agent bekerja. Untuk konteks kita, MCP yang kita bahas di episode #28 dipakai tools-tools ini untuk menyambungkan agent ke sistem eksternal seperti tracker isu atau database internal.
Apa kata datanya
Saya tidak ingin cuma cerita pengalaman. Anthropic pernah menganalisis sekitar 400.000 sesi Claude Code dari Oktober 2025 sampai April 2026 (dipublikasikan 16 Juni 2026). Temuan yang paling menarik bagi saya: porsi sesi yang dihabiskan untuk memperbaiki kode rusak turun dari 33% menjadi 19%, sementara bagian “mengoperasikan software” (menjalankan, menganalisis data, menulis dokumen non-kode) naik dari 14% ke 21%. Artinya penggunaan berpindah dari “AI tolong perbaiki error ini” ke pekerjaan end-to-end. Laporan itu juga menegaskan sesuatu yang saya rasakan sendiri: agent tidak menggantikan pemahaman — makin dalam kita paham kode dan arsitekturnya, makin bagus hasil yang bisa kita perintahkan.
Kapan pakai mana — aturan main saya
- Saya pakai completion untuk menulis boilerplate rutin dan sintaks yang hafalannya kuno.
- Saya pakai agentic edit untuk refactor lintas file, migrasi kecil, dan menulis test awal — dengan syarat review diff sebelum commit, bukan “terima semua”.
- Saya tidak memberi akses terminal bebas ke agent di kode produksi tanpa guard: perintah yang boleh jalan otomatis saya batasi dulu.
Intinya: mode completion = saya masih driver, AI hanya navigator. Mode agentic edit = AI sudah boleh menyetir, tapi tangan saya tetap di pintu dan rem tangan. Di episode berikutnya kita akan masuk ke topik yang sering bikin penasaran: bagaimana mengevaluasi apakah hasil AI ini benar-benar bagus, bukan hanya terdengar meyakinkan — yaitu evals untuk LLM dan agent.
Sumber
Sumber yang saya baca untuk catatan ini:
Komentar Terbaru