Di episode #41 kita sudah membahas multi-agent dari sudut desain: kapan orchestrator masuk akal dan kapan cuma overkill. Kali ini saya mau mendalami bagian yang lebih mendasar — bagaimana satu agent sebenarnya “berpikir” di dalam loop-nya, bagaimana merancang tool yang tidak bikin model bingung, dan kapan multi-agent benar-benar layak dipakai. Catatan ini saya susun sambil mengecek ulang sumber aslinya, karena banyak klaim soal agent yang beredar tanpa rujukan.
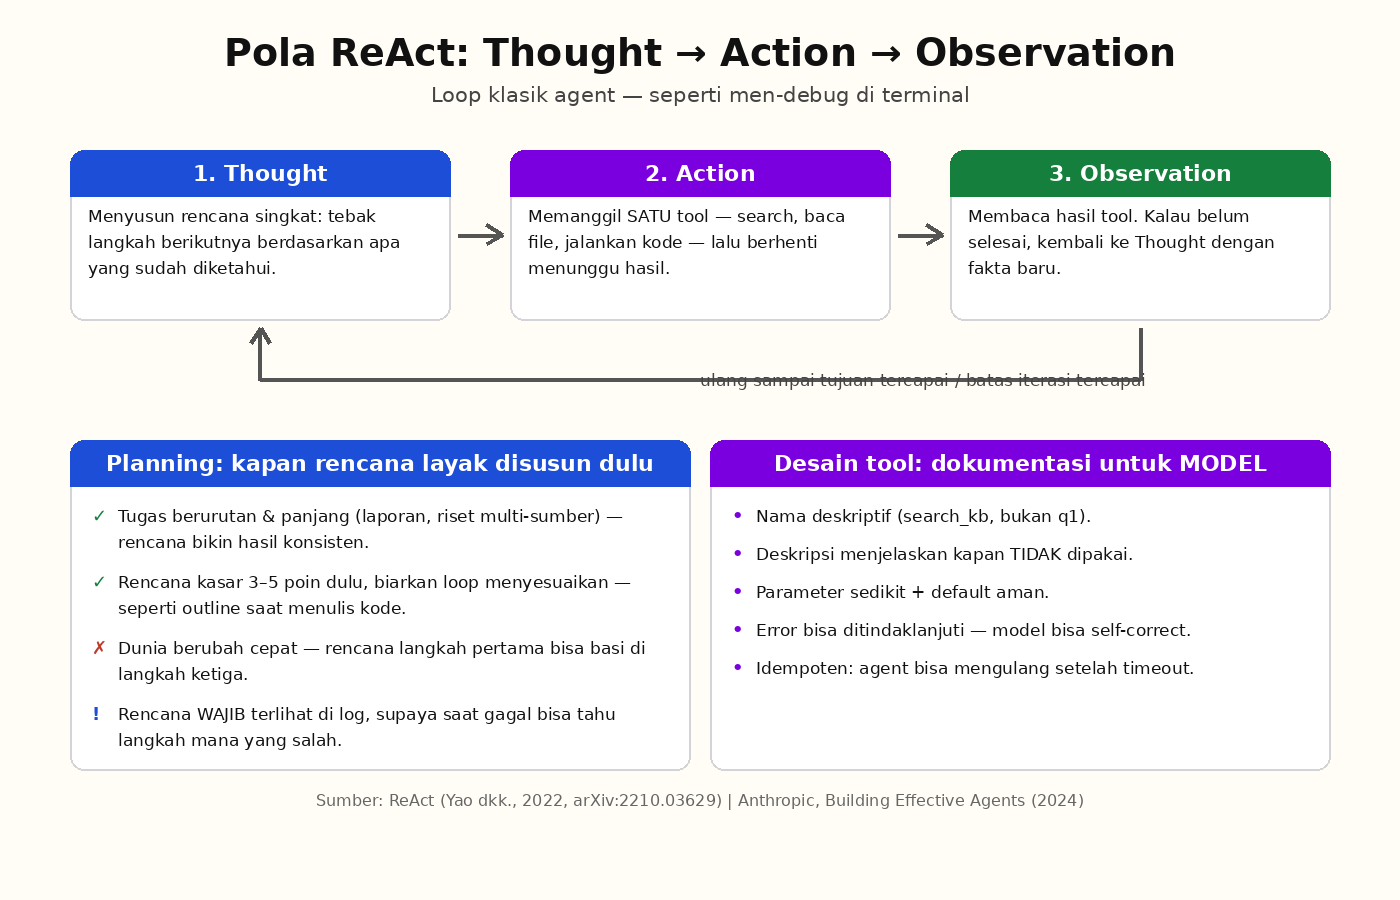
Pola ReAct: seperti men-debug dengan REPL
Pola paling klasik dalam agent adalah ReAct (Reason + Act), diperkenalkan oleh Yao dan rekan pada 2022. Idenya sederhana: model mengulang tiga langkah — Thought (menyusun rencana singkat), Action (memanggil satu tool), lalu Observation (membaca hasilnya) — sampai tujuan tercapai.
Buat saya, ini persis seperti kebiasaan men-debug di terminal. Saya baca error, tebak penyebabnya, jalankan satu perintah untuk menguji tebakan, lalu baca output-nya. Kalau masih salah, saya ulang dengan tebakan baru. Saya tidak merancang seluruh strategi debugging dari awal — saya bereaksi terhadap apa yang saya lihat. ReAct memaksa model bekerja dengan cara yang sama, dan itu membuat jejak langkahnya mudah diikuti saat terjadi kegagalan.
Planning: kapan rencana layak disusun dulu
ReAct bersifat reaktif — langkah berikutnya lahir dari hasil langkah sebelumnya. Ada varian yang kebalikannya: plan-and-execute, di mana model menyusun daftar langkah dulu baru mengeksekusi satu per satu. Dalam praktiknya saya menemukan pengaturan seperti ini:
- Rencana layak disusun dulu kalau tugasnya berurutan dan panjang — misalnya menulis laporan dengan beberapa bagian, atau riset yang butuh banyak sumber. Rencana membuat hasilnya lebih konsisten dan mudah dievaluasi per tahap.
- Rencana justru berbahaya kalau dunianya berubah cepat. Rencana yang disusun di langkah pertama bisa basi di langkah ketiga setelah tool mengembalikan fakta tak terduga. Dalam kasus ini, ReAct reaktif lebih tahan banting.
- Kompromi yang paling sering saya pakai: rencana kasar di awal (3–5 poin), lalu biarkan loop-nya menyesuaikan. Sama seperti menyusun outline saat menulis kode — saya tahu strukturnya, tapi detailnya saya serahkan ke proses.
Yang penting: rencana harus terlihat di log. Kalau rencana disembunyikan dari output, saat hasilnya jelek saya tidak bisa menyalahkan langkah mana — dan di episode #30 kita sudah belajar bahwa eval yang tidak bisa menunjuk akar masalah percuma saja.
Desain tool: dokumentasi untuk model, bukan untuk manusia
Di episode #27 kita bahas function calling dari sisi teknisnya. Sekarang sisi desainnya. Anthropic menekankan bahwa tool design dan dokumentasinya kritis — tool adalah antarmuka yang dibaca model, dan model tidak bisa menebak niat kita seperti manusia. Prinsip yang saya kumpulkan:
- Nama deskriptif, bukan singkatan internal.
search_kblebih baik dariq1. Model memilih tool berdasarkan nama dan deskripsi. - Deskripsi menjelaskan kapan TIDAK dipakai. Error paling sering yang saya lihat: model memaksa tool yang salah karena deskripsinya hanya menyebut fungsi idealnya, bukan batasnya.
- Parameter sedikit, dengan default yang aman. Setiap parameter tambahan adalah kesempatan salah isi. Kalau bisa sembunyikan opsi di balik default, sembunyikan.
- Error harus bisa ditindaklanjuti. Pesan “invalid request” membunuh loop; pesan “tanggal harus format YYYY-MM-DD, kamu kirim ‘kemarin'” membuat model langsung memperbaiki diri di iterasi berikutnya.
- Idempoten bila memungkinkan. Agent bisa mengulang panggilan setelah timeout. Tool yang menulis data dua kali karena ulangan adalah bug yang menunggu waktu.
Kalau tool-nya banyak, MCP (bahasan #28) memberi standar penyajiannya — tapi standar tidak menyelamatkan deskripsi yang buruk.
Multi-agent: revisi praktis dari #41
Setelah membaca ulang pengalaman produksi dan panduan Anthropic soal effective agents, kesimpulan praktis saya tentang multi-agent sedikit lebih tajam dari episode #41:
- Alasan utama memecah agent adalah isolasi konteks, bukan kecepatan. Satu agent yang menyeret seluruh riwayat percakapan cepat bengkak — dan ini persis masalah konteks yang kita bahas di #40. Worker terpisah berarti konteks bersih per sub-tugas.
- Parallel hanya untuk tugas yang benar-benar independen. Kalau worker saling butuh hasilnya, Anda sebenarnya butuh satu loop berurutan, bukan banyak agent.
- Koordinasi itu mahal. Setiap tambahan agent menambah panggilan model, titik gagal, dan biaya. Anthropic sendiri menyarankan memulai dari pola paling sederhana — satu panggilan augmented LLM dulu — baru naik kelas kalau solusi sederhana sudah tidak cukup.
- Tetap butuh eval per agent (#30 berlaku ganda di sini): tanpa itu, menambah agent cuma menambah misteri.
Bagi saya, pelajaran terbesar dari episode ini sederhana: agent yang baik bukan yang paling pintar loop-nya, tapi yang tool-nya jelas, langkahnya terlihat, dan keputusan “cukup, pakai yang sederhana” berani diambil lebih awal.
Sumber
- ReAct: Synergizing Reasoning and Acting in Language Models — https://arxiv.org/abs/2210.03629
- Anthropic, Building Effective Agents — https://www.anthropic.com/research/building-effective-agents
- Anthropic Cookbook: Patterns for Agents — https://github.com/anthropics/anthropic-cookbook/blob/main/patterns/agents/README.md
- Model Context Protocol — https://modelcontextprotocol.io/
Komentar Terbaru