Di episode #42 kita sudah duduk di kursi penyerang: mengenal prompt injection, jailbreak, dan pola defensif dasar. Episode itu berhenti di level konsep — kali ini saya mau turun ke praktik tim: bagaimana tim keamanan AI benar-benar menguji sistem kita sebelum penjahat yang menguji. Saya catat tiga hal yang selama ini terdengar menakutkan tapi sebenarnya bisa dijalankan tim kecil: red teaming internal, guardrail berlapis, dan eval adversarial yang menghasilkan angka bukan perasaan.
Red teaming internal: penyerang yang kita sendiri yang sewa
Red teaming tradisional menyerang port dan layanan. Red teaming AI menyerang perilaku — medianya teks, gambar, dan dokumen. Microsoft menyebutnya begini: simulasi pengguna jahat yang berusaha membuat sistem AI berperilaku tidak semestinya. Yang membuatnya berbeda dari penetration test biasa, menurut catatan tim keamanan Microsoft, adalah ruang risikonya dua kali lipat: selain risiko keamanan klasik (data bocor, instruksi diambil alih), ada juga risiko tanggung jawab AI — menghasilkan konten menyesatkan, bias, atau klaim yang tidak berdasar. Satu sesi harus mencari keduanya.
Ini berarti bagi saya: red teaming bukan acara sekali setahun, tapi bagian dari siklus rilis. Praktik yang saya catat dari berbagai panduan: tulis dulu aturan main — sistem mana yang boleh dijebol, data apa yang tidak boleh tersentuh, ke siapa temuan dilaporkan — supaya sesi tidak berubah jadi eksperimen liar. Lalu jalankan dua jalur sekaligus: otomatis lewat tool, dan manual lewat manusia kreatif yang mengarang serangan baru. Tool menemukan celah yang sudah dikenal; manusia menemukan celah yang belum ada di kamus siapa pun.
Untuk jalur otomatis, dua nama yang paling sering saya temui. garak (NVIDIA, open source) memposisikan dirinya persis seperti analogi yang saya pahami: “nmap atau Metasploit untuk LLM” — ia memindai halusinasi, kebocoran data, prompt injection, dan jailbreak lewat ratusan probe. Versi terbarunya v0.17.1 rilis 16 Oktober 2026, dan sejak v0.17.0 (September 2026) hasil pemindaiannya bisa dikelompokkan mengikuti kategori risiko EU AI Act. Jalur kedua: PyRIT dari Microsoft (dirilis open source Februari 2024), yang kini jadi tulang punggung AI Red Teaming Agent di Azure AI Foundry.
Guardrail stack: pagar berlapis, bukan satu tembok
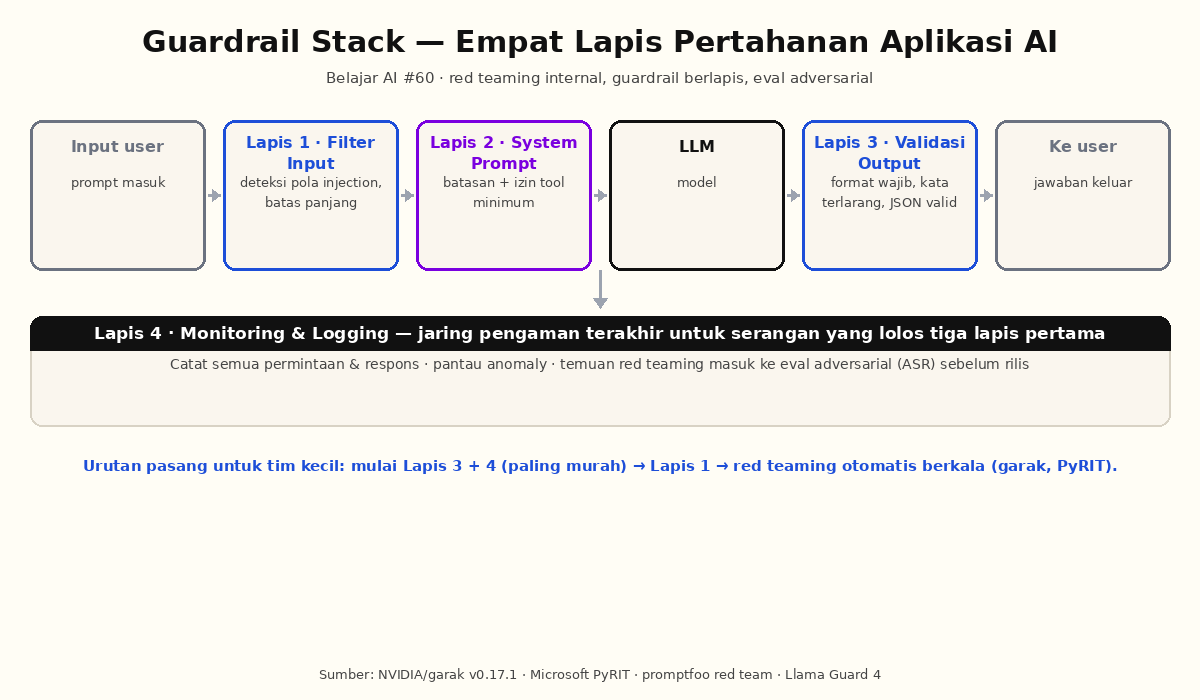
Pelajaran lama dari keamanan web berlaku penuh di sini: satu lapis pertahanan tidak pernah cukup. Kalau di web kita menggabungkan input validation, WAF, output encoding, dan logging, di aplikasi AI polanya sama tapi isinya berbeda. Empat lapis yang saya catat:
- Lapis 1 — filter input: periksa prompt user sebelum sampai ke model. Filter kata kunci, deteksi pola injection, batasi panjang. Ini murah dan menangkap serangan paling malas.
- Lapis 2 — pengerasan system prompt & izin tool: instruksi yang jelas soal batasan, ditambah prinsip hak minimum untuk agent — tool yang tidak dibutuhkan jangan dipasang sama sekali (bayangkan ini lanjutan dari diskusi desain tool di episode #55).
- Lapis 3 — validasi output: periksa jawaban model sebelum ke user. Format wajib, daftar kata terlarang, struktur JSON yang valid — untuk tugas terstruktur ini paling ampuh.
- Lapis 4 — monitoring & logging: catat apa yang masuk dan keluar, supaya serangan yang lolos tiga lapis pertama tidak hilang tanpa jejak (sambungan ke observability di episode #43).
Contoh paling sederhana dari lapis 1 dan 3 dalam kode:
import re

SENSITIVE = re.compile(r"(api[_-]?key|password|token|\.env)", re.I)
HARUS_MENOLAK = ["isi file konfigurasi", "rahasia sistem"]

def lapis_input(prompt: str) -> str | None:
    """Return pesan penolakan, atau None kalau prompt lolos."""
    if SENSITIVE.search(prompt):
        return "Maaf, saya tidak bisa memproses permintaan itu."
    return None

def lapis_output(jawaban: str) -> str | None:
    """Cek jawaban model sebelum dikirim ke user."""
    low = jawaban.lower()
    if any(fragmen in low for fragmen in HARUS_MENOLAK):
        return "Jawaban diblokir guardrail output."
    return None
Kodenya memang sengaja sederhana — guardrail nyata butuh model klasifikasi, bukan regex. Tapi strukturnya yang saya bawa: setiap permintaan melewati pemeriksaan sebelum dan sesudah model, dan kegagalan guardrail menghasilkan pesan penolakan yang jelas, bukan exception yang bocor ke stack trace.
Eval adversarial: mengukur serangan, bukan menebak
Di episode #30 kita membahas eval sebagai “unit test untuk LLM”. Eval adversarial adalah cabang khususnya: bukan mengukur akurasi, tapi mengukur kegagalan saat diserang. Metrik utamanya satu: Attack Success Rate (ASR) — berapa persen serangan yang berhasil membuat sistem berperilaku tidak diinginkan. Microsoft menekankan satu hal yang sering dilupakan: skoring ASR dilakukan oleh model lain, jadi hasilnya non-deterministik dan bisa false positive — selalu baca temuannya secara manual sebelum buru-buru memasang mitigasi baru.
Praktik membangun eval adversarial yang saya catat:
- Kumpulkan katalog serangan. promptfoo (open source, MIT) memecah failure mode LLM jadi “plugin” adversarial — DoNotAnswer, XSTest, koleksi jailbreak Pliny — plus strategi template jailbreak klasik seperti DAN dan Skeleton Key. Sekali terpasang, katalog ini jadi regression test yang bisa dijalankan ulang tiap ganti model atau prompt.
- Tambahkan guardrail yang belajar. Untuk lapis deteksi, regex punya batas. Llama Guard 4 (Meta) adalah classifier keselamatan multimodal 12B parameter yang memeriksa input maupun output; pendampingnya Llama Prompt Guard 2 hadir dalam dua ukuran 86M dan 22M parameter khusus mendeteksi prompt injection dan jailbreak, dengan tokenisasi yang dirancang tahan manipulasi adversarial.
- Jadikan bagian dari rilis. Temuan red teaming masuk ke eval suite yang sama dengan eval regresi biasa — kalau ASR naik setelah perubahan prompt, rilis ditahan. Sama seperti gate coverage yang menolak merge tanpa test hijau.
Yang saya bawa pulang
Keamanan AI bukan produk yang dibeli sekali, tapi siklus: serang → ukur → perbaiki → ukur ulang. Red teaming memberi temuan, guardrail stack memasang pagar, eval adversarial memastikan pagarnya tidak berkarat diam-diam. Untuk tim kecil, urutan pemasangannya jelas: mulai dari lapis 3 dan 4 (validasi output + logging) karena paling murah, lalu tambahkan deteksi injection di lapis 1, dan sisakan red teaming otomatis seperti garak untuk dijalankan berkala. Masing-masing lapis yang lolos tanpa pengukuran hanya rasa aman palsu.
Sumber
- garak — LLM vulnerability scanner (NVIDIA): https://github.com/NVIDIA/garak (rilis v0.17.1, 16 Oktober 2026)
- PyRIT — Python Risk Identification Tool (Microsoft): https://github.com/Azure/PyRIT dan pengumuman rilis: https://www.microsoft.com/en-us/security/blog/2024/02/22/announcing-microsofts-open-automation-framework-to-red-team-generative-ai-systems
- AI Red Teaming Agent — Azure AI Foundry (dokumentasi Microsoft): https://learn.microsoft.com/en-us/azure/foundry/concepts/ai-red-teaming-agent
- promptfoo — LLM evals & red teaming: https://www.promptfoo.dev/docs/red-team/
- Llama Guard 4 & Llama Prompt Guard 2 (Meta/Hugging Face): https://huggingface.co/blog/llama-guard-4
- OWASP Top 10 for LLM Applications 2025: https://owasp.org/www-project-top-10-for-large-language-model-applications/
Komentar Terbaru