Di episode #31 kita sudah membandingkan prompting, RAG, dan fine-tuning, lalu di #33 masuk ke embedding dan vector database. Kali ini saya mau merapikan semuanya jadi satu checklist produksi: apa saja yang harus ada supaya RAG di aplikasi sungguhan tidak cuma demo yang kelihatan bagus di laptop. Ini yang saya catat setelah menyusun ulang pipeline RAG di proyek kecil saya sendiri.
Ingestion pipeline: bagian yang paling sering disepelekan
Bagian retrieval yang berat justru dimulai sebelum model bicara. Pipeline ingestion yang saya anggap wajib: ambil sumber → bersihkan (buang header navigasi, footer, tabel sampah) → pecah (chunking) → embed → simpan beserta metadata (judul, URL, tanggal, sumber).
Dua hal yang saya pelajari dengan cara susah: pertama, chunking tetap. Ukuran 300–500 token dengan overlap 10–20% adalah titik awal yang aman, tapi dokumen structured (FAQ, API reference) lebih baik dipecah per-judul, bukan per-karakter. Kedua, simpan metadata sejak awal — kalau nanti perlu filter (hanya dokumen dari 2026 saja, hanya bahasa Indonesia), mengulang ingestion dari nol itu menyakitkan. Ini konsisten dengan apa yang kita bahas soal hybrid search di #33: filter metadata + keyword search + vector search lebih sering menang daripada vector search murni.
Re-ranking: layer murah yang sering menaikkan kualitas paling besar
Pola standar 2026 adalah retrieval dua tahap: stage 1 mengambil kandidat banyak (50–100) dengan cepat pakai keyword + vector, stage 2 memakai model reranker (mis. bge-reranker atau Cohere Rerank) untuk mengurutkan ulang 20–30 kandidat teratas. Reranker membaca pasangan (pertanyaan, dokumen) langsung, jadi lebih akurat dari sekadar kemiripan vektor — harganya satu inference tambahan per query, jauh lebih murah daripada menaikkan ukuran embedding model.
Ini berarti bagi saya: kalau kualitas jawaban terasa “ambil yang mirip tapi tidak nyambung”, coba tambah reranker dulu sebelum ganti vector DB atau fine-tune embedding model. Reranking sering menyelesaikan masalahnya.
Evaluasi RAG: groundedness, recall, dan yang paling susah dinilai
Di #30 kita sudah bicara eval sebagai “unit test untuk LLM”. Untuk RAG ada tiga metrik yang selalu saya ukur:
- Context recall — apakah dokumen yang diambil benar-benar memuat jawaban yang dibutuhkan? Kalau ini rendah, masalahnya di retriever, bukan di model.
- Groundedness (faithfulness) — apakah jawaban model benar-benar diturunkan dari konteks yang diberikan, bukan karangan? Ini yang menjaga jawaban tidak “pede tapi salah”.
- Answer relevancy — apakah jawaban menjawab pertanyaan yang benar-benar ditanya?
Framework seperti RAGAS (arXiv:2309.15217) mengotomasi ketiganya dengan memakai LLM sebagai juri. Saya memakainya untuk regression test: tiap kali ubah chunking atau tambah dokumen, jalankan ulang set eval berisi 30–50 kasus tetap dan bandingkan skornya. Set eval kecil yang stabil lebih berguna daripada benchmark besar yang tidak pernah dijalankan dua kali.
Failure mode nyata yang saya temui
- Konteks benar tapi terkubur. Penelitian “Lost in the Middle” (arXiv:2307.03172) menunjukkan model paling memperhatikan awal dan akhir konteks. Kalau dokumen kunci berada di tengah-tengah 10 chunk, ia bisa terlewat — urutkan kandidat paling relevan di posisi pertama, dan pertimbangkan ringkas dokumen panjang sebelum masuk konteks.
- Index basi. Dokumen diperbarui tapi vektor lama masih terlayani. Solusi sederhana: simpan hash/versi dokumen, jalankan re-index terjadwal, bandingkan jumlah dokumen di index dengan sumber.
- Pertanyaan di luar korpus. User bertanya hal yang tidak ada di dokumen, model tetap menjawab dari ingatan. Fix: instruksi eksplisit “jawab hanya dari konteks, kalau tidak ada katakan tidak tahu” + flag “sumber tidak ditemukan” di UI.
- Semantik query yang aneh. Singkatan internal perusahaan (“SLA-3”) tidak cocok dengan dokumen. HyDE atau query expansion kadang membantu; hybrid search dengan keyword biasanya menyelamatkan kasus ini.
- Biaya membengkak diam-diam. Query panjang + chunk besar = token konteks berlipat tiap request. Batasi jumlah chunk yang dikirim, pakai prompt caching kalau system prompt + korpus statis.
Checklist singkat sebelum RAG dinyatakan “siap”
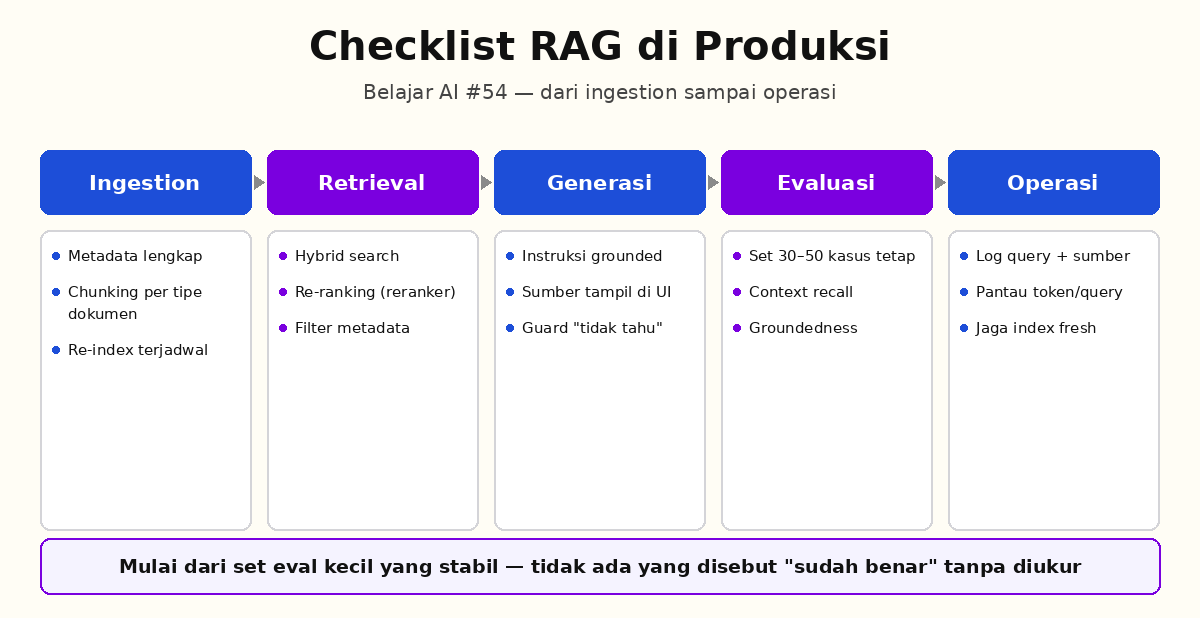
| Tahap | Cek |
|---|---|
| Ingestion | Metadata lengkap, chunking per tipe dokumen, re-index terjadwal |
| Retrieval | Hybrid search + reranker, filter metadata tersedia |
| Generasi | Instruksi grounded, sumber ditampilkan di UI, guard “tidak tahu” |
| Evaluasi | Set eval tetap 30–50 kasus, ukur recall + groundedness tiap perubahan |
| Operasi | Log query & sumber terpilih, pantau token/query, siap re-index |
Pelajaran terbesar saya: RAG bukan sekadar “vector database + prompt”. Kualitasnya ditentukan di hulu — ingestion dan retrieval — sementara eval yang membuat kita tahu perubahan kita membantu atau merusak. Mulai dari set eval kecil dulu, lalu iterasi. Itu prinsip yang sama dengan yang kita pakai untuk agent: tidak ada yang disebut “sudah benar” tanpa diukur.
Sumber
— RAGAS: Automated Evaluation of Retrieval Augmented Generation (arXiv:2309.15217)
— Lost in the Middle: How Language Models Use Long Contexts (arXiv:2307.03172)
— Rerankers & dense retrieval (Qdrant)
Komentar Terbaru